3. 编程接口
机器学习框架为什么使用函数式编程
- 支持高效的科学计算和机器学习场景:函数的表达形式更加接近于数学思维
- 易于开发并行:避免状态变化和数据可变
- 简洁的代码标识能力
函数式编程能更直观的表达机器学习模型,同时对于自动微分、高阶求导、分布式的实现也更加方便
函数式编程和面向对象编程是两种不同的编程范式,它们有着各自的特点和目标。以下是它们的主要特点和显著区别:
函数式编程的特点:
- 纯函数:函数式编程鼓励使用纯函数,即不依赖于外部状态或副作用的函数。纯函数的输出仅由输入决定,不会对外部环境产生任何影响。
- 不可变性:函数式编程倾向于使用不可变数据,即数据一旦创建就不能被修改。这有助于编写可靠、可维护和线程安全的代码.
- 高阶函数和函数组合:函数式编程鼓励使用高阶函数(函数接受函数作为参数或返回函数)和函数组合(将多个函数组合成一个新函数)的方式来构建程序。
- 递归:函数式编程通常使用递归来解决问题,而不是使用循环。递归在函数式编程中是一种常见的迭代方式。
面向对象编程的特点:
- 对象和类:面向对象编程将程序组织为对象的集合,每个对象都有自己的状态(属性)和行为(方法)。对象是类的实例,类是对象的抽象描述。
- 封装和信息隐藏:面向对象编程通过封装将数据和对数据的操作封装在对象内部,以限制对数据的直接访问,并确保数据的一致性和安全性。
- 继承和多态:面向对象编程支持继承和多态的概念。继承允许定义一个类基于另一个类,并继承其属性和方法。多态允许使用相同的接口处理不同类型的对象,实现代码的灵活性和可复用性。
显著区别: - 数据和行为的组织方式:函数式编程将重点放在函数上,数据和行为分离,通过函数的组合和转换来处理数据。而面向对象编程将重点放在对象上,数据和行为封装在对象内部。
- 可变性:函数式编程倾向于使用不可变数据,避免副作用和共享状态。面向对象编程允许对象的状态发生变化,支持可变性。
- 迭代方式:函数式编程通常使用递归来进行迭代,而面向对象编程使用循环和迭代器等方式进行迭代。
- 设计思维:函数式编程更加注重函数的纯洁性、模块化和函数的组合,强调问题的解决方式。面向对象编程更加注重对象的封装性、继承性和多态性,强调问题的建模和抽象。
需要注意的是,函数式编程和面向对象编程并不是互斥的,可以在同一个程序中结合使用它们的特性。Python 是一种多范式的编程语言,既支持函数式编程也支持面向对象编程,并且提供了丰富的功能和库来支持这两种编程范式。选择使用哪种编程范式取决于问题的性质、团队的偏好和代码的可维护性等因素。
4. 计算图
计算图的作用
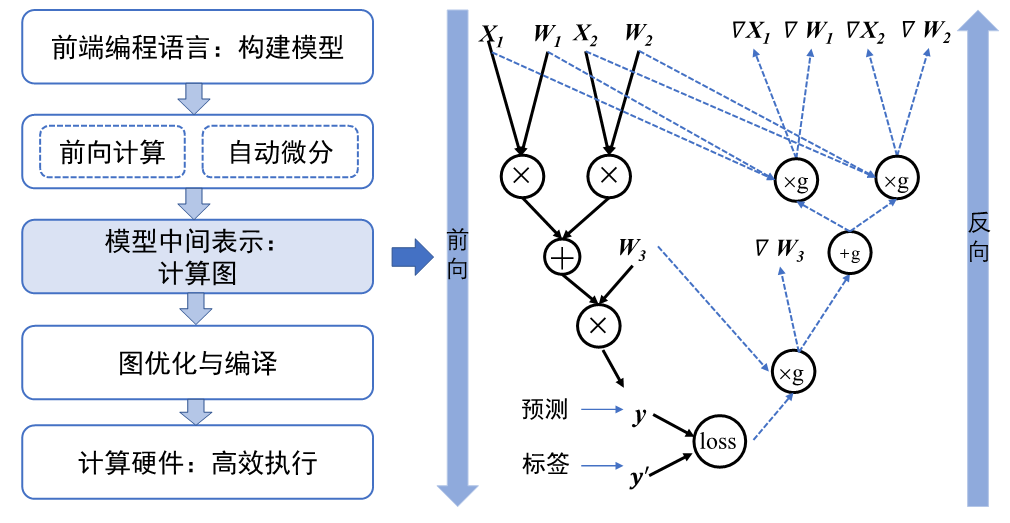
- 统一的计算过程表达:硬件加速设备只提供了c/c++编程接口,因此用高层次语言编写的程序需要被表达为一个统一的数据结构
- 自动化计算图梯度:计算图可以辅助机器学习系统快速分析参数之间的梯度传递关系,实现自动化计算梯度的目标
- 分析模型变量生命周期:准确判断中间变量(如前向计算中的激活值和反向计算中的梯度)的生命周期(生成和销毁时机),帮助框架优化内存管理
- 优化程序执行:机器学习框架利用计算图来分析模型结构和算子执行依赖关系,自动寻找算子并行计算的策略,提高模型的执行效率
计算图的构成
节点表示算子,节点间的有向边表示张量状态,如
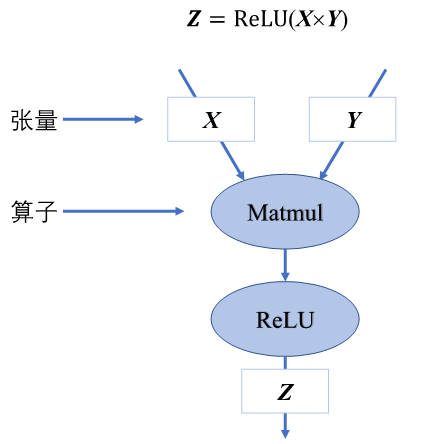
算子
可以按照功能将算子分类为张量操作算子、神经网络算子、数据流算子和控制流算子等
- 张量操作算子:包括张量的结构操作(如维度调整和张量合并等)和数学运算
- 神经网络算子:包括特征提取(卷积操作就是特征提取算子)、激活函数、损失函数、优化算法等
- 数据流算子:含数据的预处理与数据载入相关算子,数据预处理算子主要是针对图像数据和文本数据的裁剪填充、归一化、数据增强等操作。数据载入算子通常会对数据集进行随机乱序(Shuffle)、分批次载入(Batch)以及预载入(Pre-fetch)等操作。
- 控制流算子:可以控制计算图中的数据流向,当表示灵活复杂的模型时需要控制流。
- 主流的机器学习框架中通常使用两种方式来提供控制流:(1)前端语言控制流(例如python中的if-else、while等)(2)机器学习框架控制原语(也称为图内方法),提供更加细粒度的控制管理(例如TensorFlow中的tf.cond、tf.while_loop等)在获得性能提升的同时可以适配不支持前端语言运行环境的后端硬件
- 循环控制流基本上是通过展开实现的,对每一次操作赋予独特的运算标识符,来区分相同运算的多次调用,以排除循环依赖
基于链式法则计算梯度
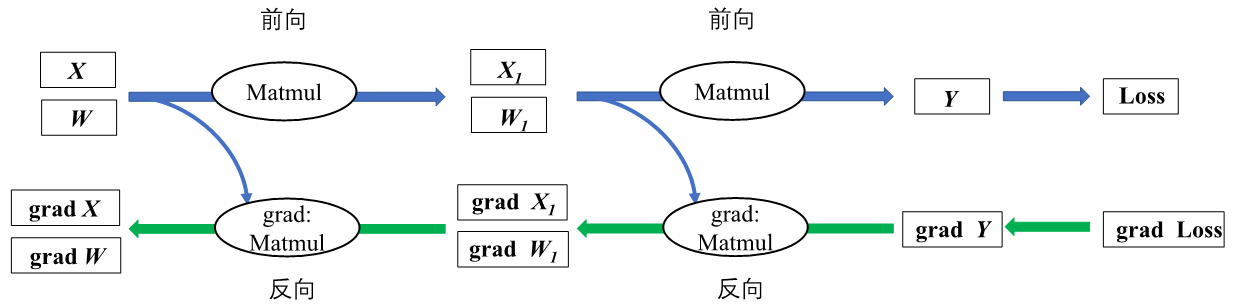
参与计算图中参数的梯度信息计算过程的不仅有后序网络层传递而来的梯度信息,还包含有前向计算中的中间结果和参数数值。
构建反向计算图时,会对计算过程进行分析保存模型中的中间结果和梯度传递状态,通过占用部分内存复用计算结果达到提高反向传播计算效率的目的。
推广到更加一般的情况,结合控制流的灵活构造,机器学习框架均可以利用计算图快速分析出前向数据流和反向梯度流的计算过程,正确的管理中间结果内存周期,更加高效的完成计算任务。
计算图生成
机器学习框架中可以生成静态图和动态图两种计算图,主流机器学习框架TensorFlow、MindSpore均支持动态图和静态图模式;Pytorch则可以通过工具构建的动态图神经网络转换为静态结构,以获得高效的计算执行效率
静态生成
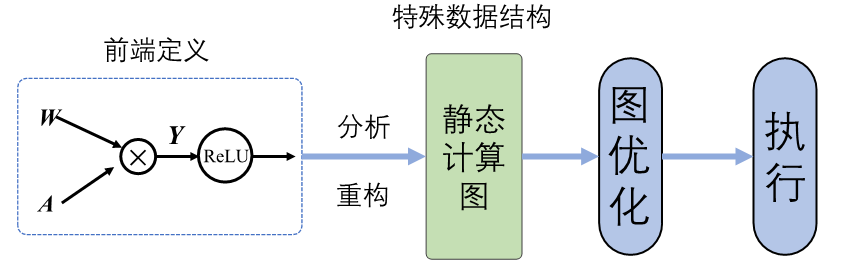
使用前端语言定义模型形成完整的程序表达后,机器学习框架首先对神经网络模型进行分析,获取网络层之间的连接拓扑关系以及参数变量设置、损失函数等信息。静态计算图可以通过优化策略转换成等价的更加高效的结构,提高后端硬件的计算效率。
机器学习框架在进行静态生成编译时并不读取输入数据,此时需要一种特殊的张量来表示输入数据辅助构建完整的计算图,这种特殊张量就被称为:数据占位符(Placeholder )
在静态计算图执行计算阶段网络接收数据流入,调度条件控制算子根据输入数据进行逻辑判断,控制数据流入不同的分支计算子图中进行后续计算。在部分机器学习框架中前端语言Python的控制流不能够被正确编译为等价的静态图结构,因此需要机器学习框架的控制原语来实现控制流。
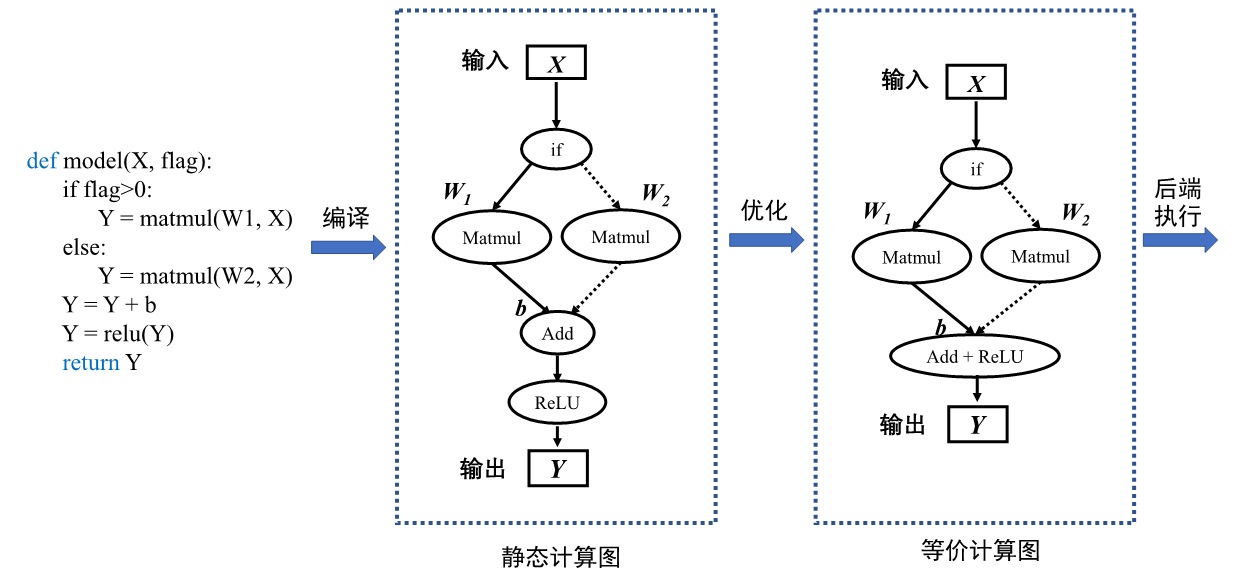
静态图的两大优势:
- 计算性能:静态图经过机器学习框架编译时能够获取模型完整的图拓扑关系。机器学习框架掌控全局信息便更容易制定计算图的优化策略,比如算子融合将网络中的两个或多个细粒度的算子融合为一个粗粒度算子,可节省中间计算结果的存储、读取等过程,降低框架底层算子调度的开销,从而提升执行性能和效率,降低内存开销。
- 直接部署:在部署模型进行应用时,可以将静态计算图序列化保存。在模型推理阶段,执行序列化的模型即可,无需重新编译前端语言源代码。机器学习框架可以将静态计算图转换为支持不同计算硬件直接调用的代码。
动态生成
动态图采用解析式的执行方式,核心特点是编译与执行同时发生,采用前端语言自身的解释器对代码进行解析,利用机器学习框架本身的算子分发功能
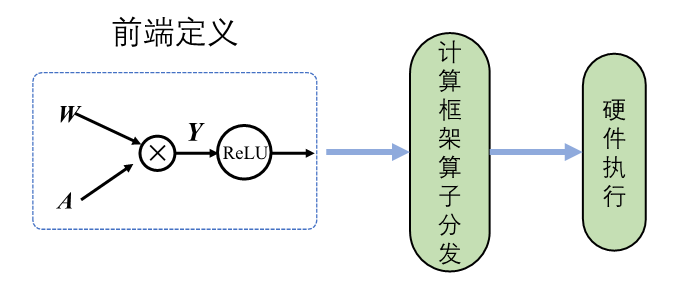
静态图和动态图除了在前端语言表达上略有差异,本质的区别在于编译执行过程。使用前端语言构建完成模型表达后,动态生成并不采用机器学习框架编译器生成完整的静态计算图,而是采用前端语言的解释器Python API调用机器学习框架,框架利用自身的算子分发功能,将Python调用的算子在相应的硬件如CPU、GPU、NPU等上进行加速计算,然后再将计算结果返回给前端。该过程并不产生静态的计算图,而是按照前端语言描述模型结构,按照计算依赖关系进行调度执行,动态生成临时的图拓扑结构。
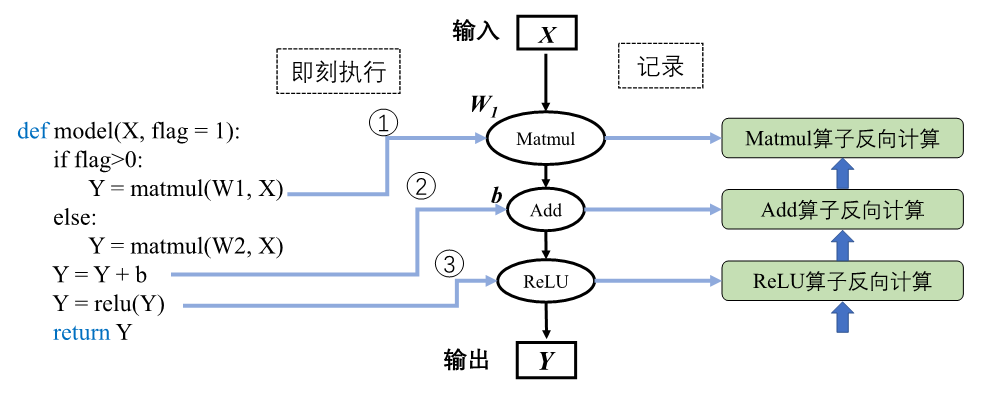
动态生成的图结构并不能完整表示前端语言描述的模型结构,需要即时根据控制条件和数据流向产生图结构。由于机器学习框架无法通过动态生成获取完整的模型结构,因此动态图模式下难以进行模型优化以提高计算效率。
在执行前向过程中,机器学习框架根据前向算子的调用信息,记录对应的反向算子信息以及参与梯度计算的张量信息。前向计算完毕之后,反向算子与张量信息随之完成记录,机器学习框架会根据前向动态图拓扑结构,将所有反向过程串联起来形成整体反向计算图。最终,将反向图在计算硬件上执行计算得到梯度用于参数更新。
动态图和静态图比较
| 特性 | 静态图 | 动态图 |
|---|---|---|
| 即时获取中间结果 | 否 | 是 |
| 代码调试难易 | 难 | 易 |
| 控制流实现方式 | 特定的语法 | 前端语言语法 |
| 性能 | 优化策略多,性能更佳 | 图优化受限,性能较差 |
| 内存占用 | 内存占用少 | 内存占用相对较多 |
| 内存占用 | 可直接部署 | 不可直接部署 |
对于上述的例子,若对代码进行静态生成,机器学习框架可以构建完整的计算图。分析可知,计算
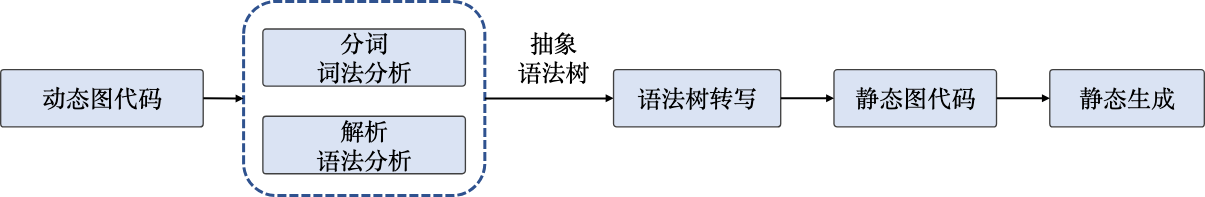
动态图转换为静态图
| 框架 | 动态图转静态图 |
|---|---|
| TensorFlow | @tf_function追踪算子调度构建静态 图,其中AutoGraph机制可以自动转换控制流为静态表达 |
| MindSpore | contex t.set_context(mode=context.PYNATIVE_MODE)动态图模 式,context.set_context(mode=context.GRAPH_MODE) 静态图模式,@ms_function支持基于源码转换 |
| PyTorch | torch.jit.script()支 持基于源码转换,torch.jit.trace()支持基于追踪转换 |
| PaddlePaddle | paddle.jit.to_static()支持基于源码转换 ,paddle.jit.TracedLayer.trace()支持基于追踪转换 |
- 基于追踪转换:以动态图模式执行并记录调度的算子,构建和保存为静态图模型。
- 基于源码转换:分析前端代码来将动态图代码自动转写为静态图代码,并在底层自动帮用户使用静态图执行器运行。
可以将整体模型动态图代码全部转换为静态图代码,提高计算效率并用于硬件部署。同时也可以将整体模型中的部分函数转化为局部静态子图,静态子图会被机器学习框架视为一个完整的算子并嵌入动态图中。执行整体动态图时,当计算到对应的函数会自动调用静态子图。使用该方式既提高了计算效率,又在一定程度上保留代码调试改进的灵活性。
@ms_function #mindspore中基于源码转换的函数装饰器,可以将该函数转换为静态图
def add_and_relu(Y, b):
    Y = Y + b
    Y = relu(Y)
    return Y

def model(X, flag):
    if flag>0:
        Y = matmul(W1, X)
    else:
        Y = matmul(W2, X)
        Y = add_and_relu(Y, b)
    return Y
计算图的调度
微观上单次迭代需要考虑计算图内部的调度执行问题,根据计算图结构、计算依赖关系、计算控制分析算子的执行调度。优化计算图的调度和执行性能,目的是尽可能充分利用计算资源,提高计算效率,缩短模型训练和推理时间。
在深度学习中,当数据集和参数量的规模越来越大在分发数据与算子时通信消耗会随之而增加,计算设备会在数据传输的过程中处于闲置状态。此时采用同步与异步的任务调度机制可以更好的协调通信与训练任务,提高通信模块与计算设备的使用率。
TensorFlow中的控制流
Implementation of Control Flow in TensorFlow
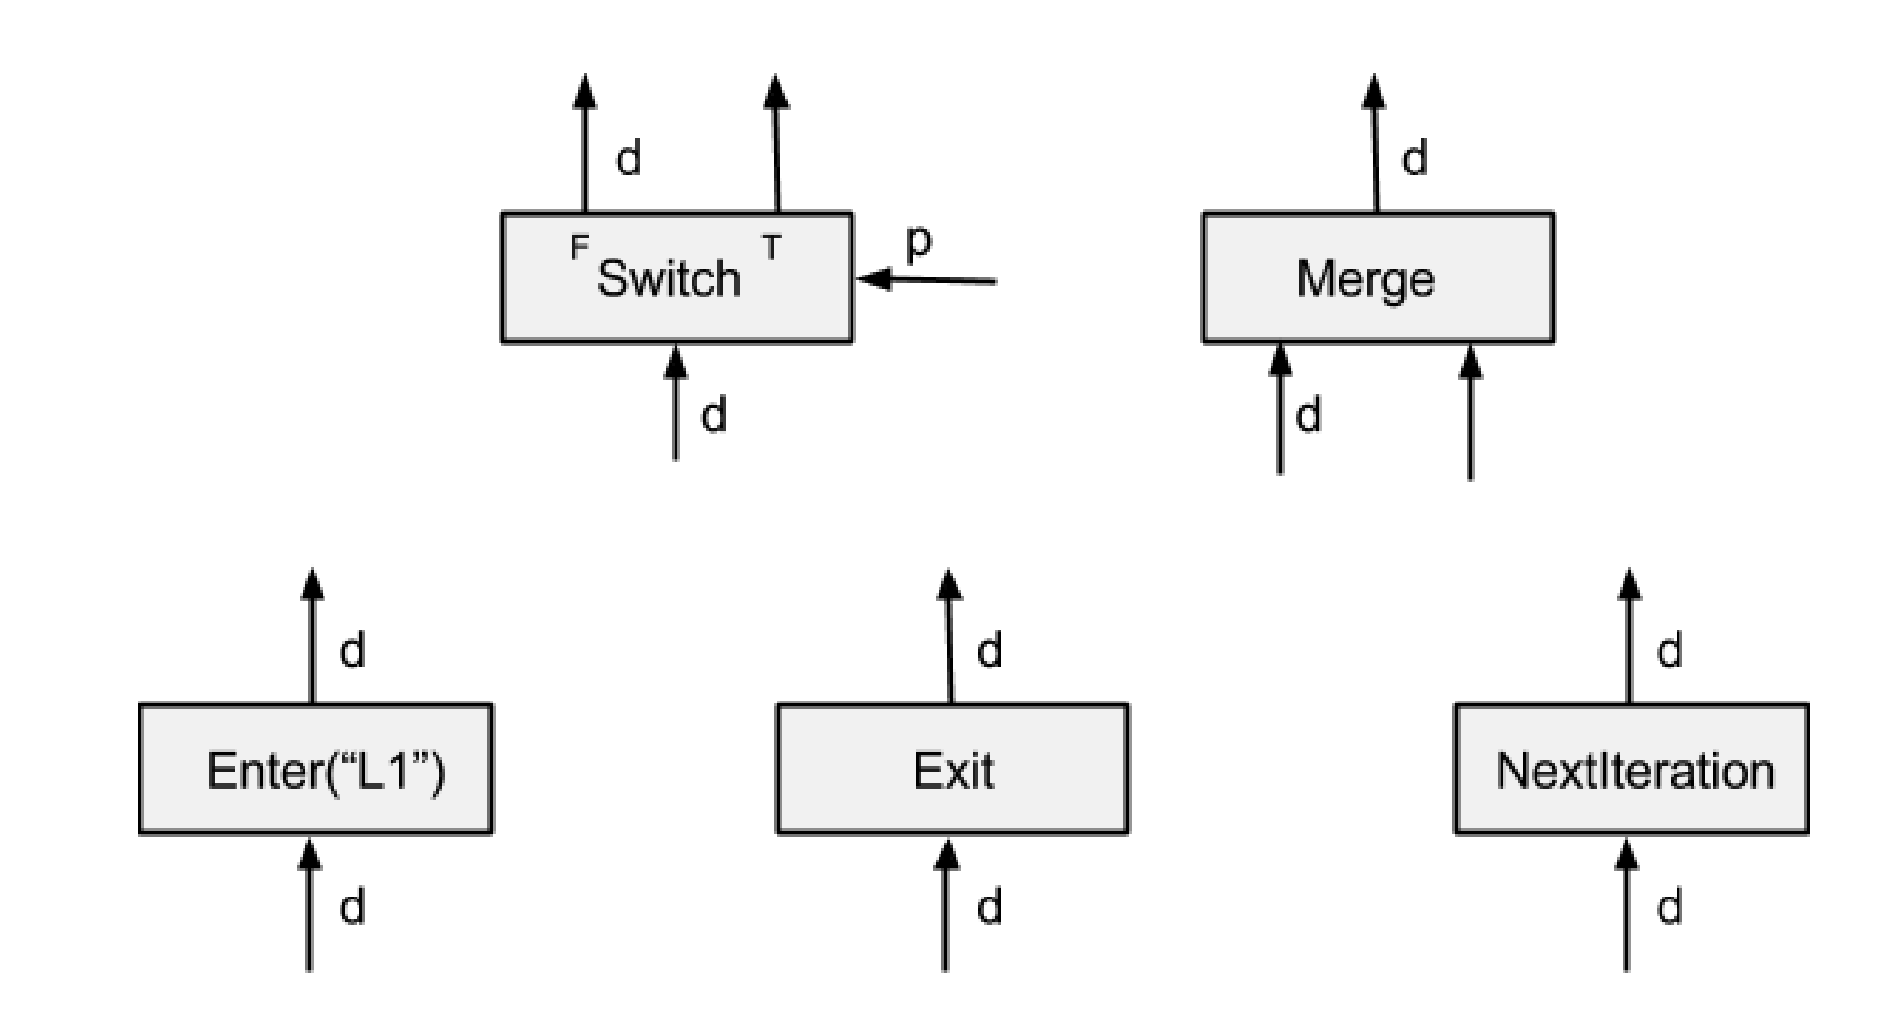
实现的控制流原语
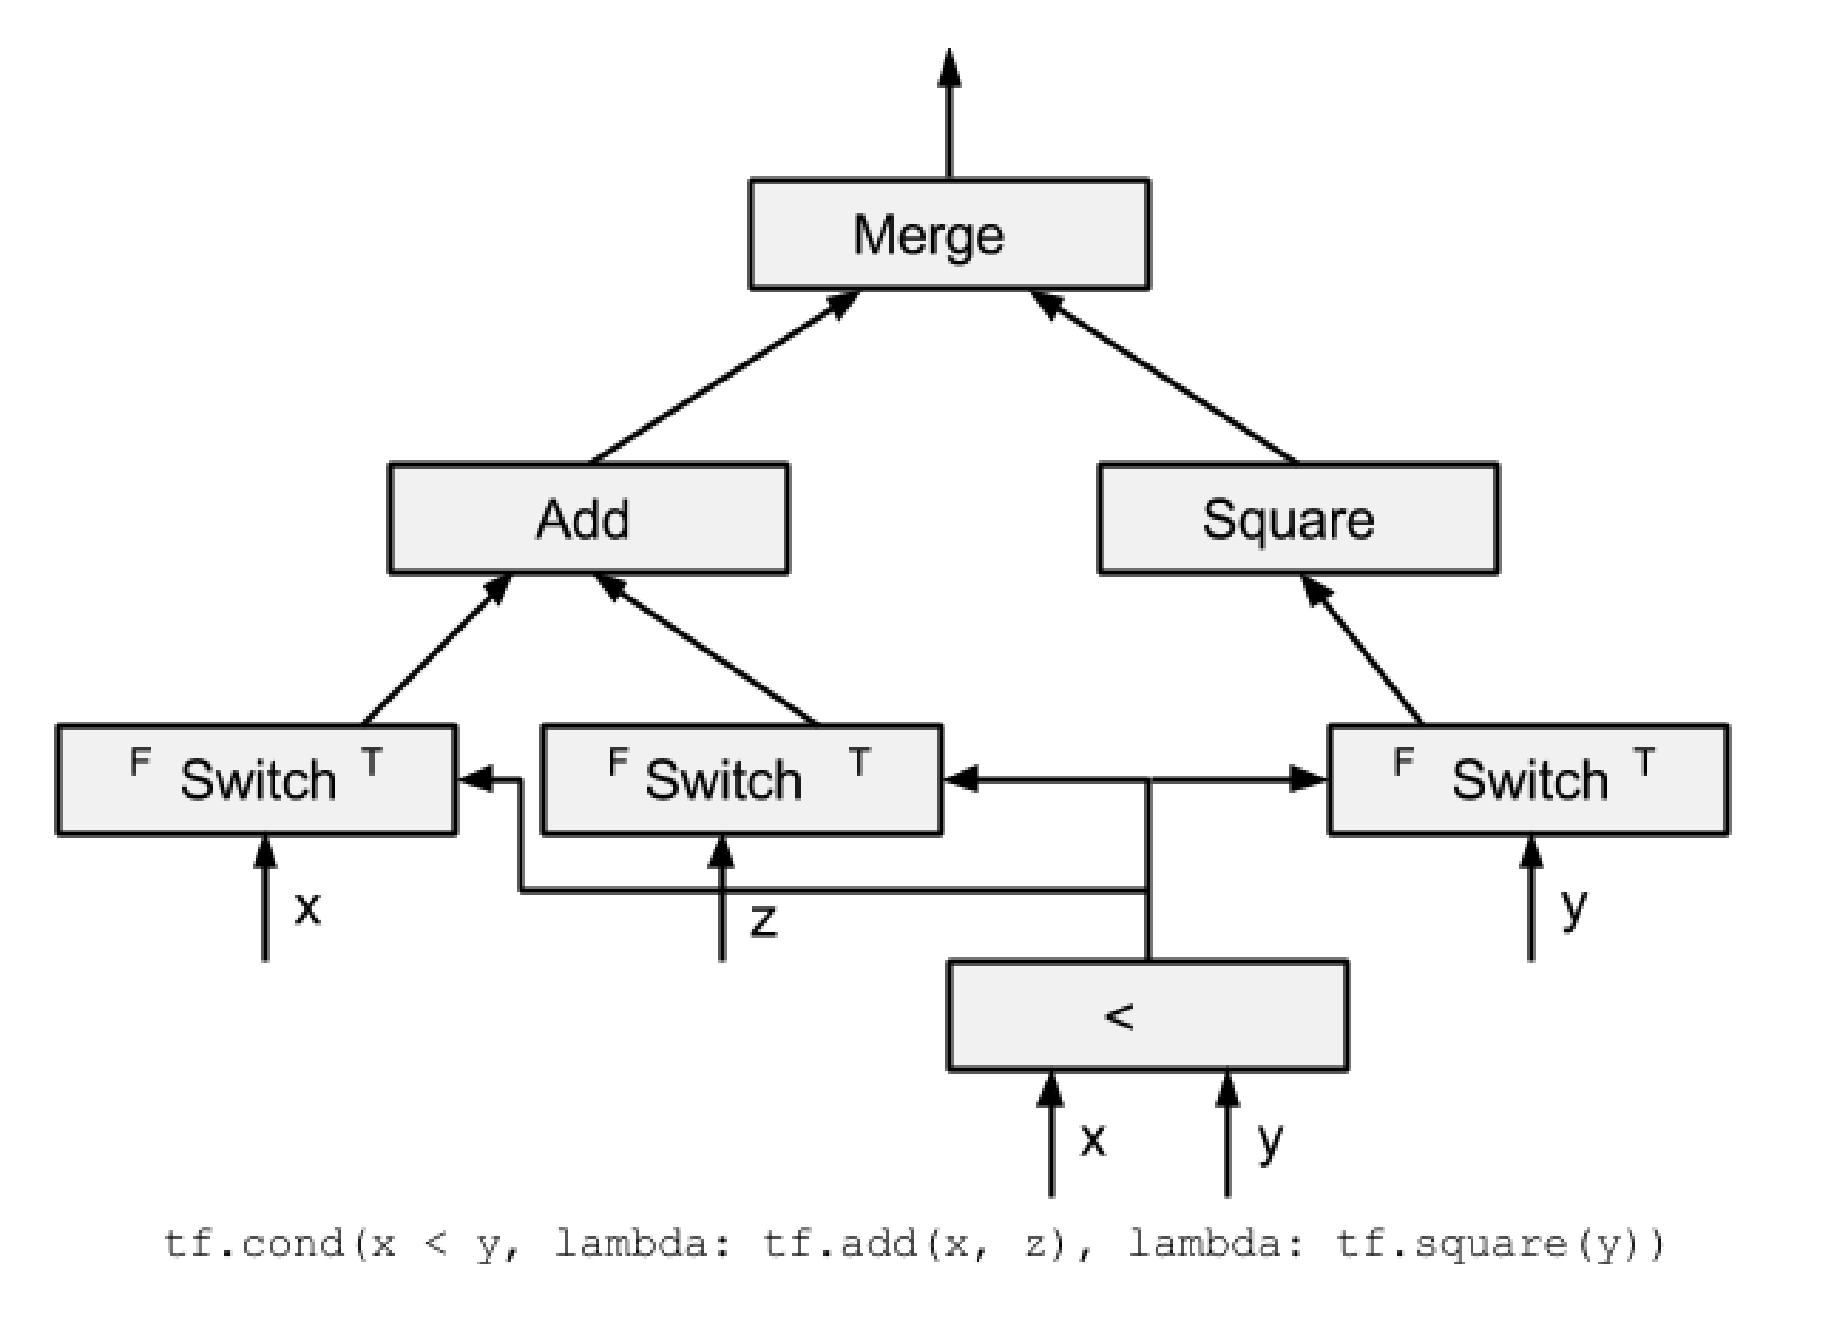
条件语句(cond)利用控制流原语生成的计算图
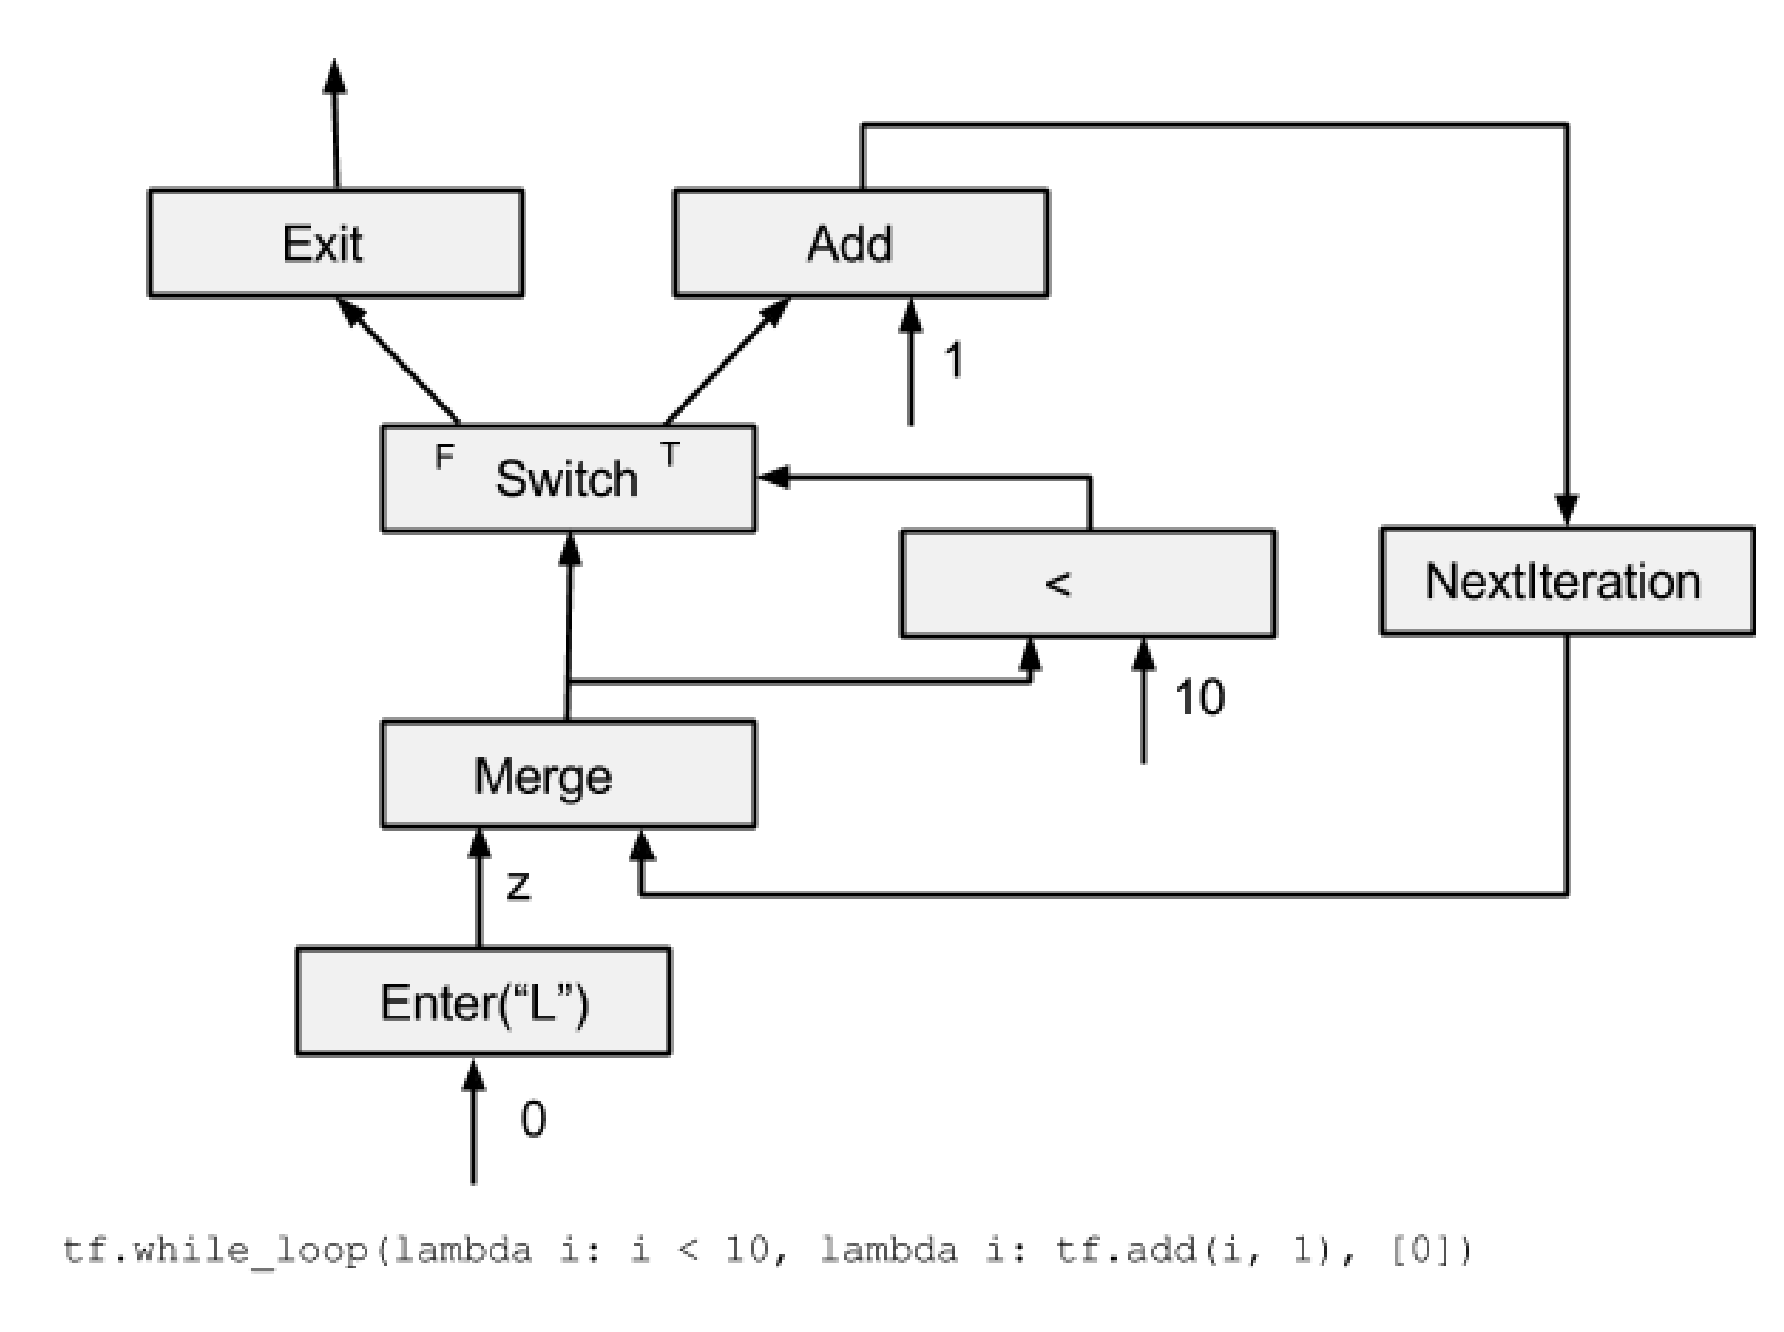
循环语句(while-loop)利用控制流原语生成的计算图
分布式控制流
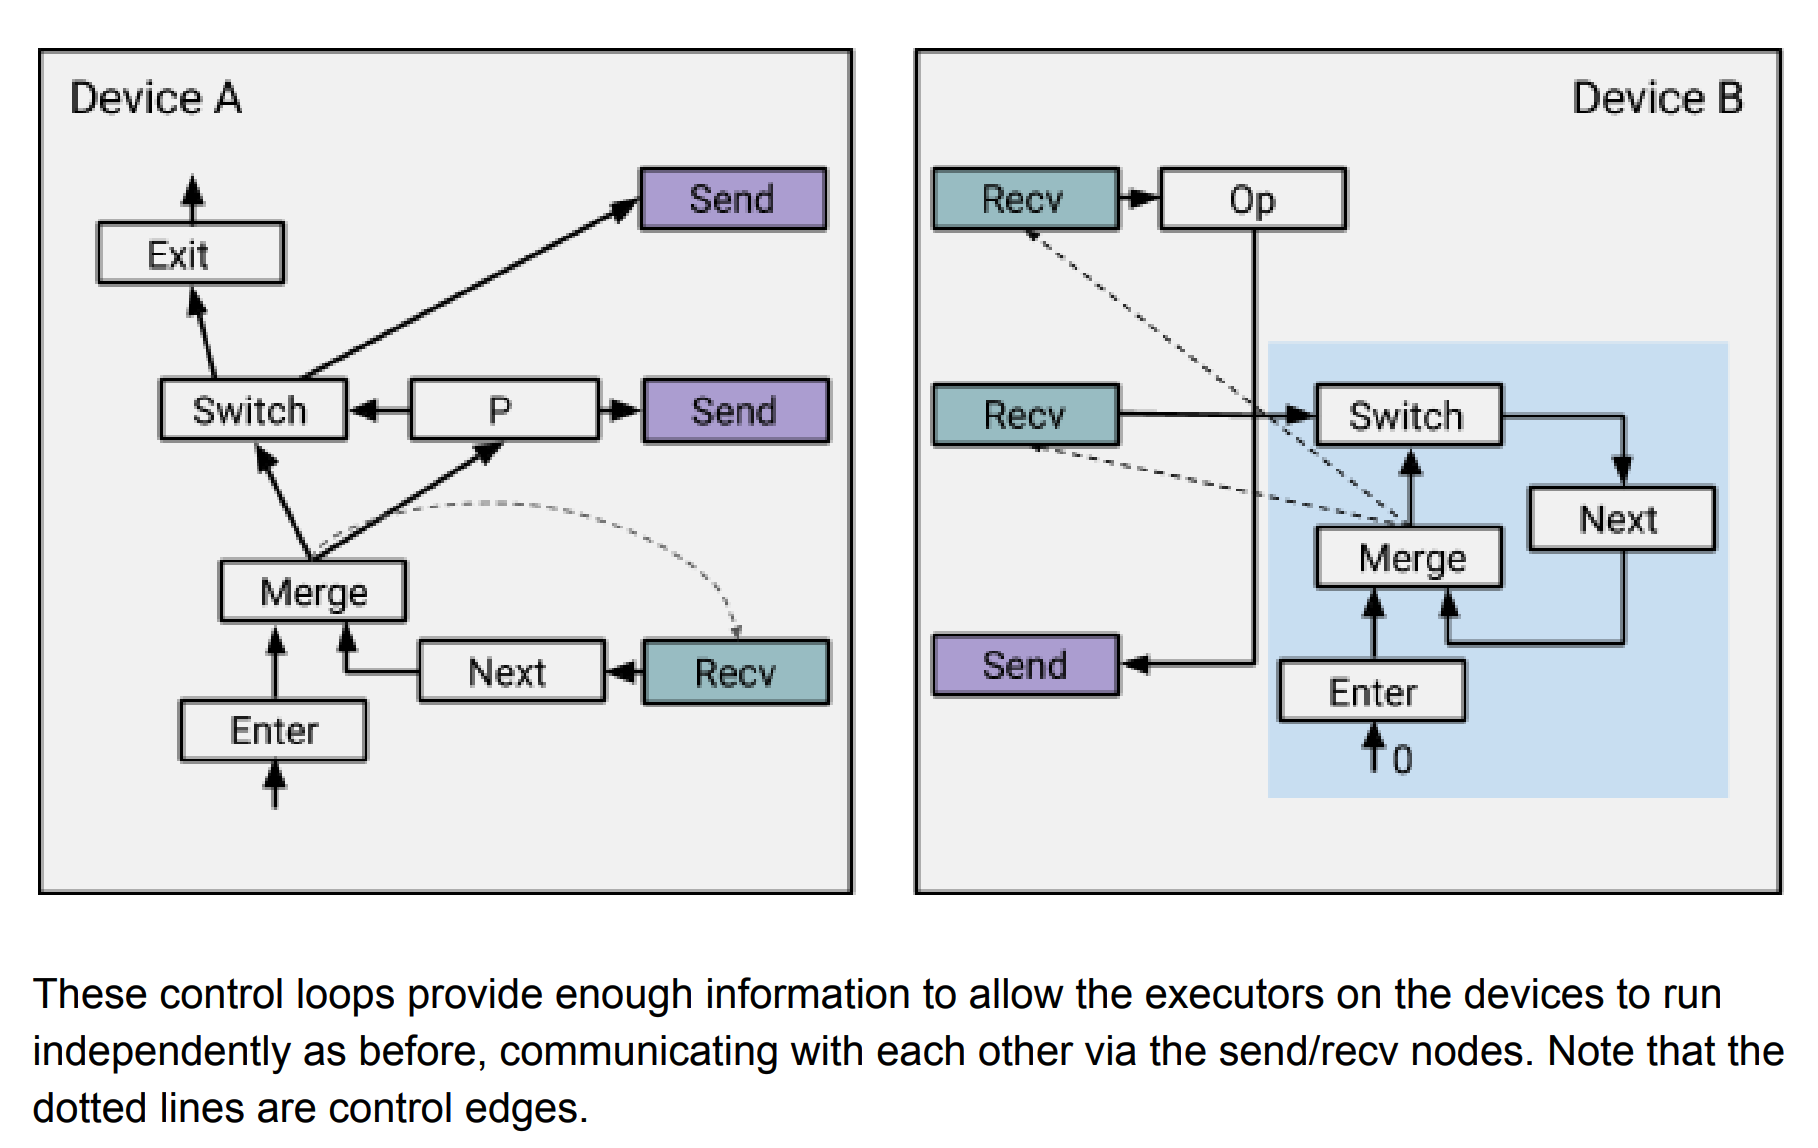
控制流生成的计算图可以被很方便的分发到不同的设备上进行分布式的执行,各broken edge之间通过加入一对send/recv节点来进行通信,注意原语和分布式的设计都是为了保证执行计算的时候是异步的,以增加并行度
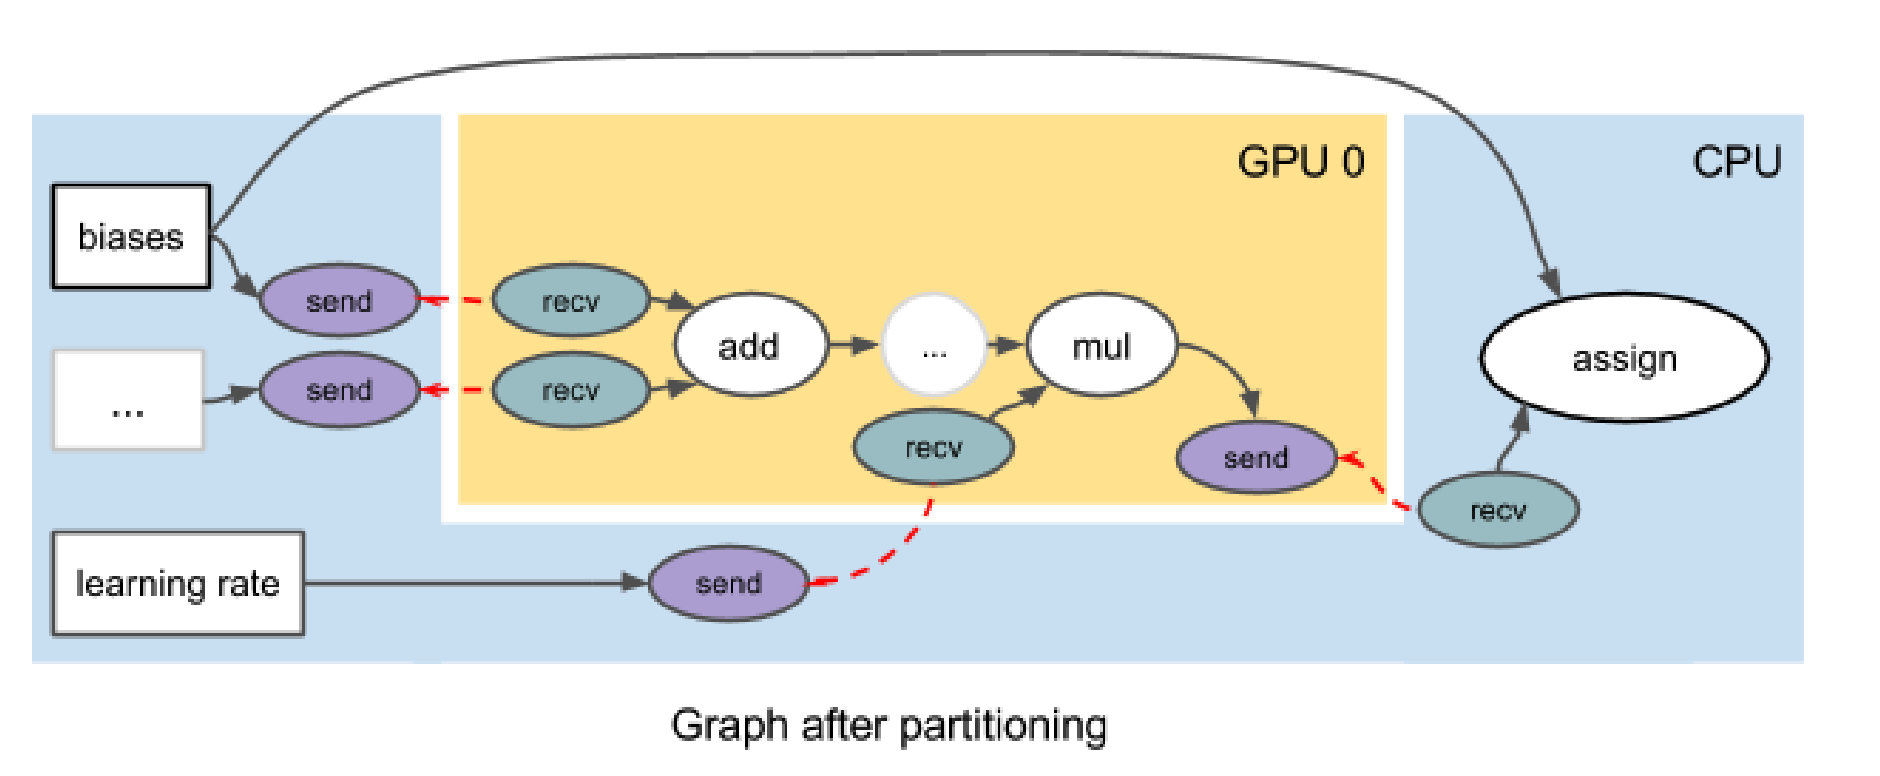
while-loop在进行分布式分发的时候,可能会出现某一个设备没有足够的信息而进行一次计算就停止执行的情况,这个时候需要在设备中加入一个新的控制块
控制流的自动微分
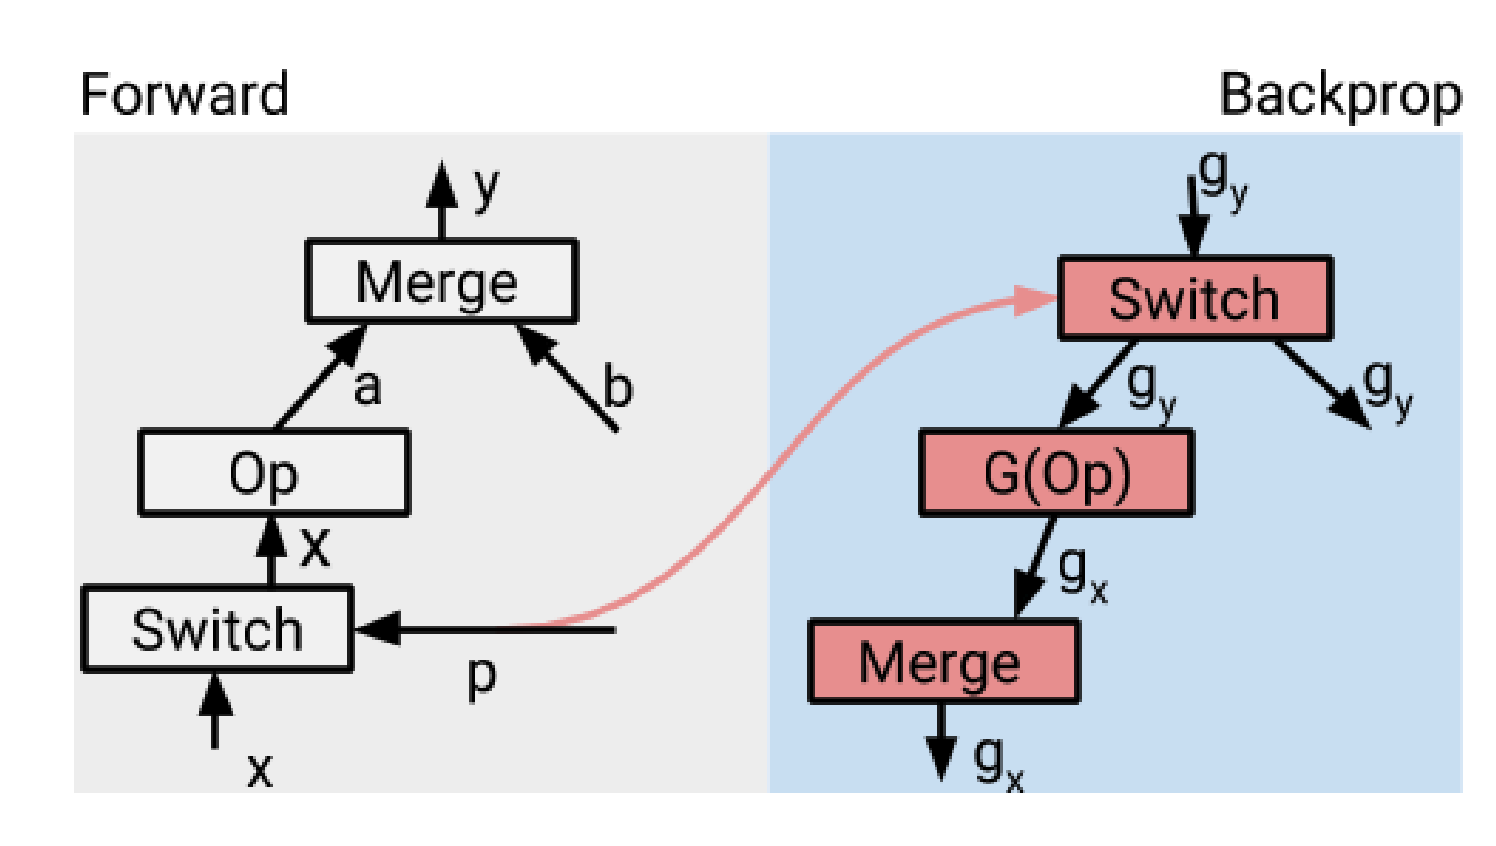
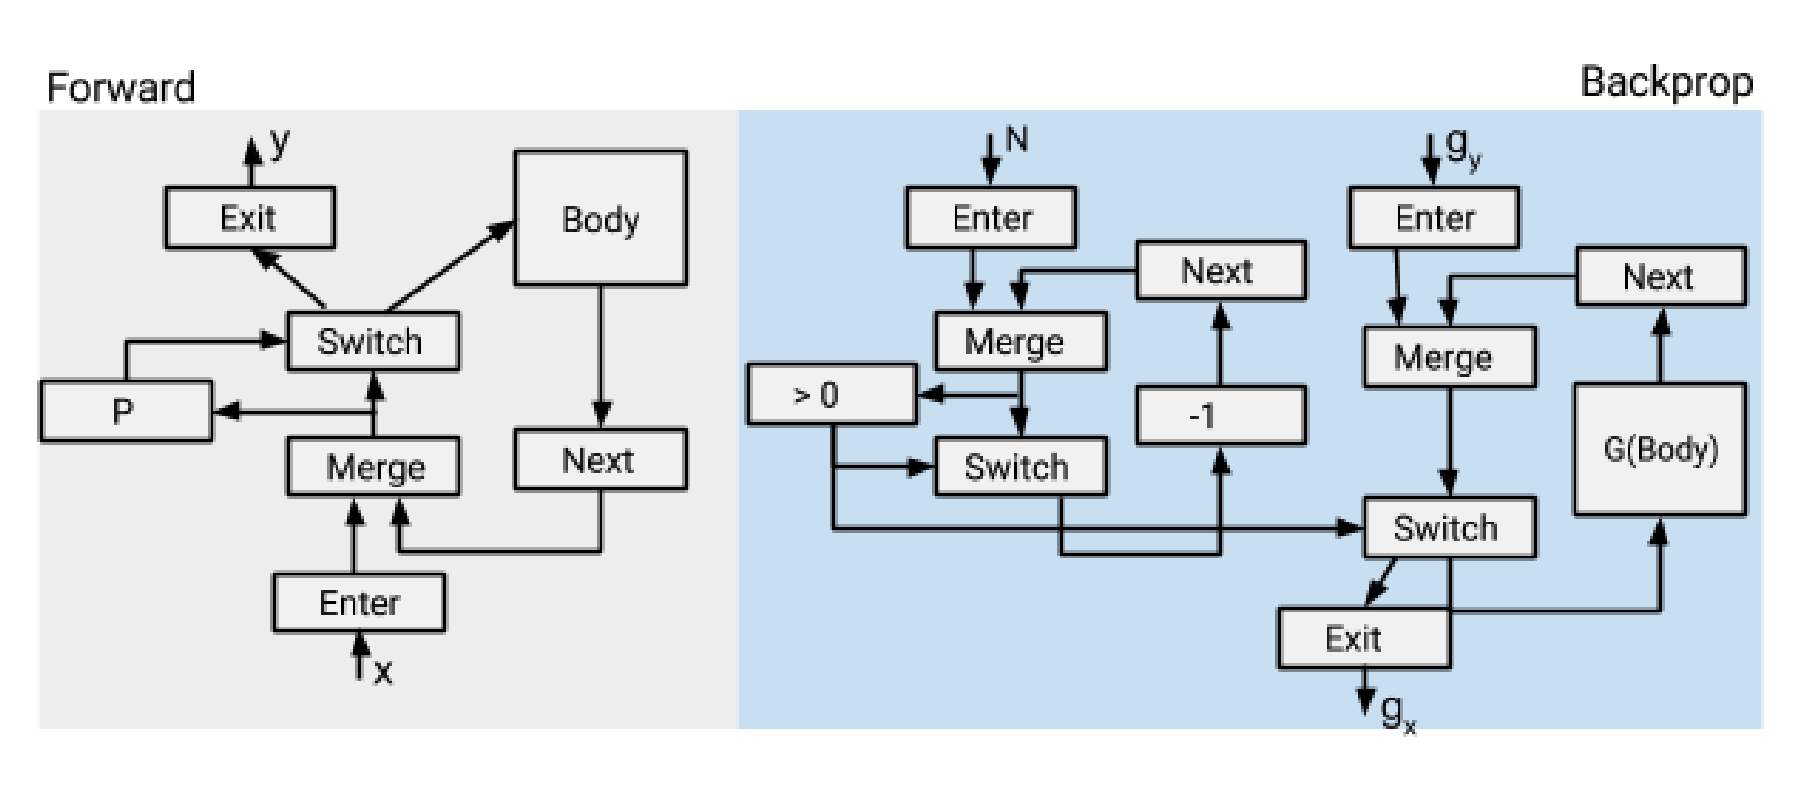
对于控制流算子的(反向传播)微分通过以下的规定执行:
The gradient of Exit is Enter; the gradient of Switch is either Merge (for cond) or NextIteration followed by Merge (for while_loop); the gradient of Merge is Switch; the gradient of NextIteration is Identity; and the gradient of Enter is Exit. TensorFlow supports the backpropagation of nested conditionals and while loops.
- 条件语句
- 循环语句
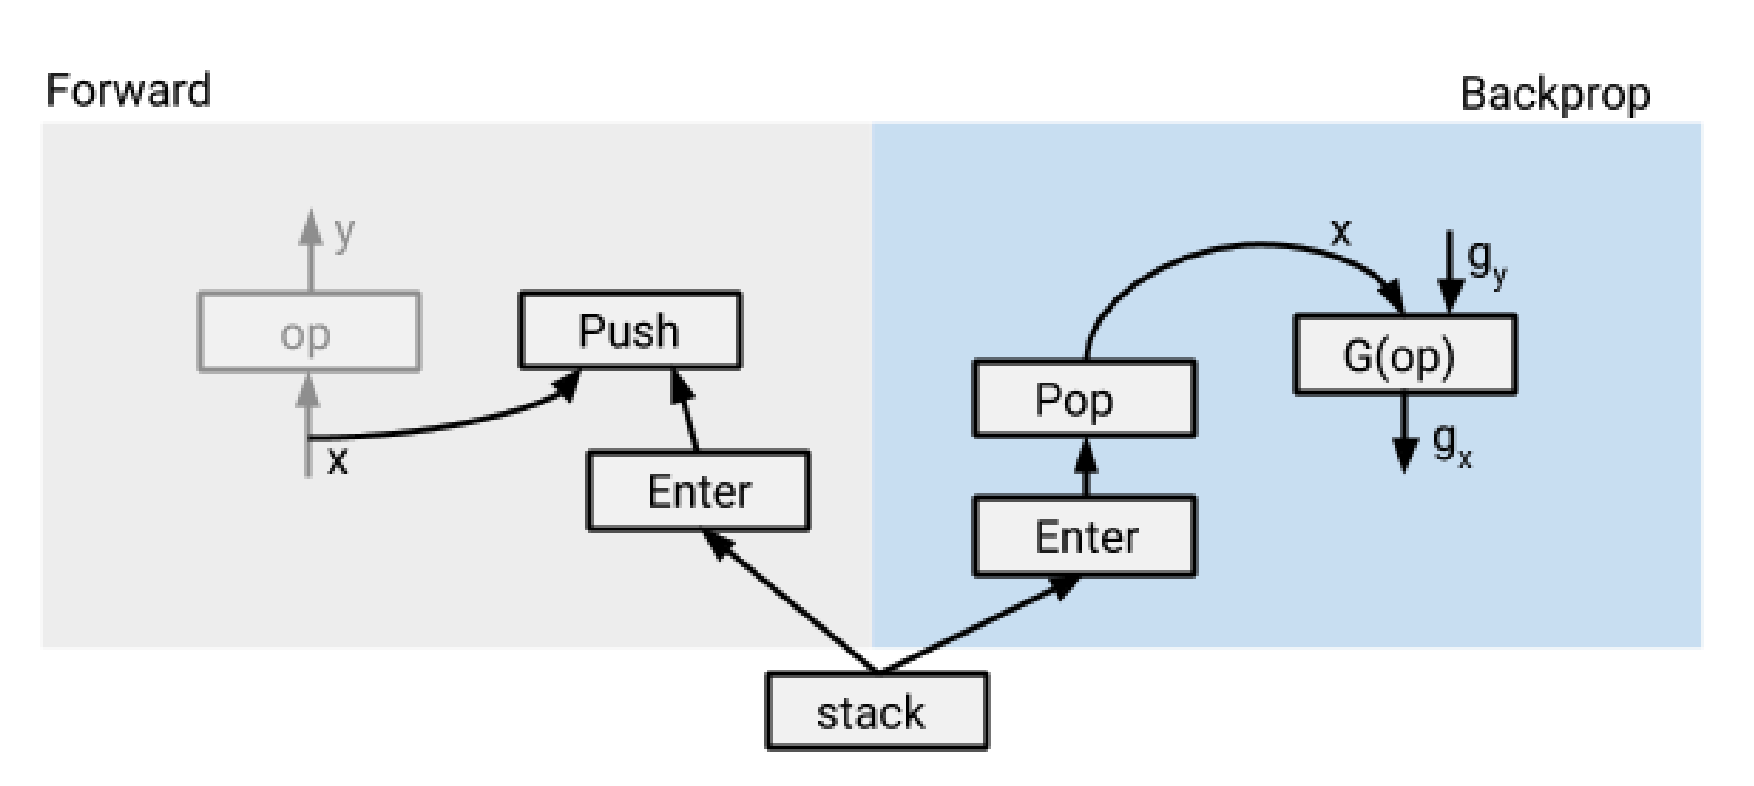
其中反向传播的时候利用的是通过在前向传播的时候加入一个计算块计算出来的
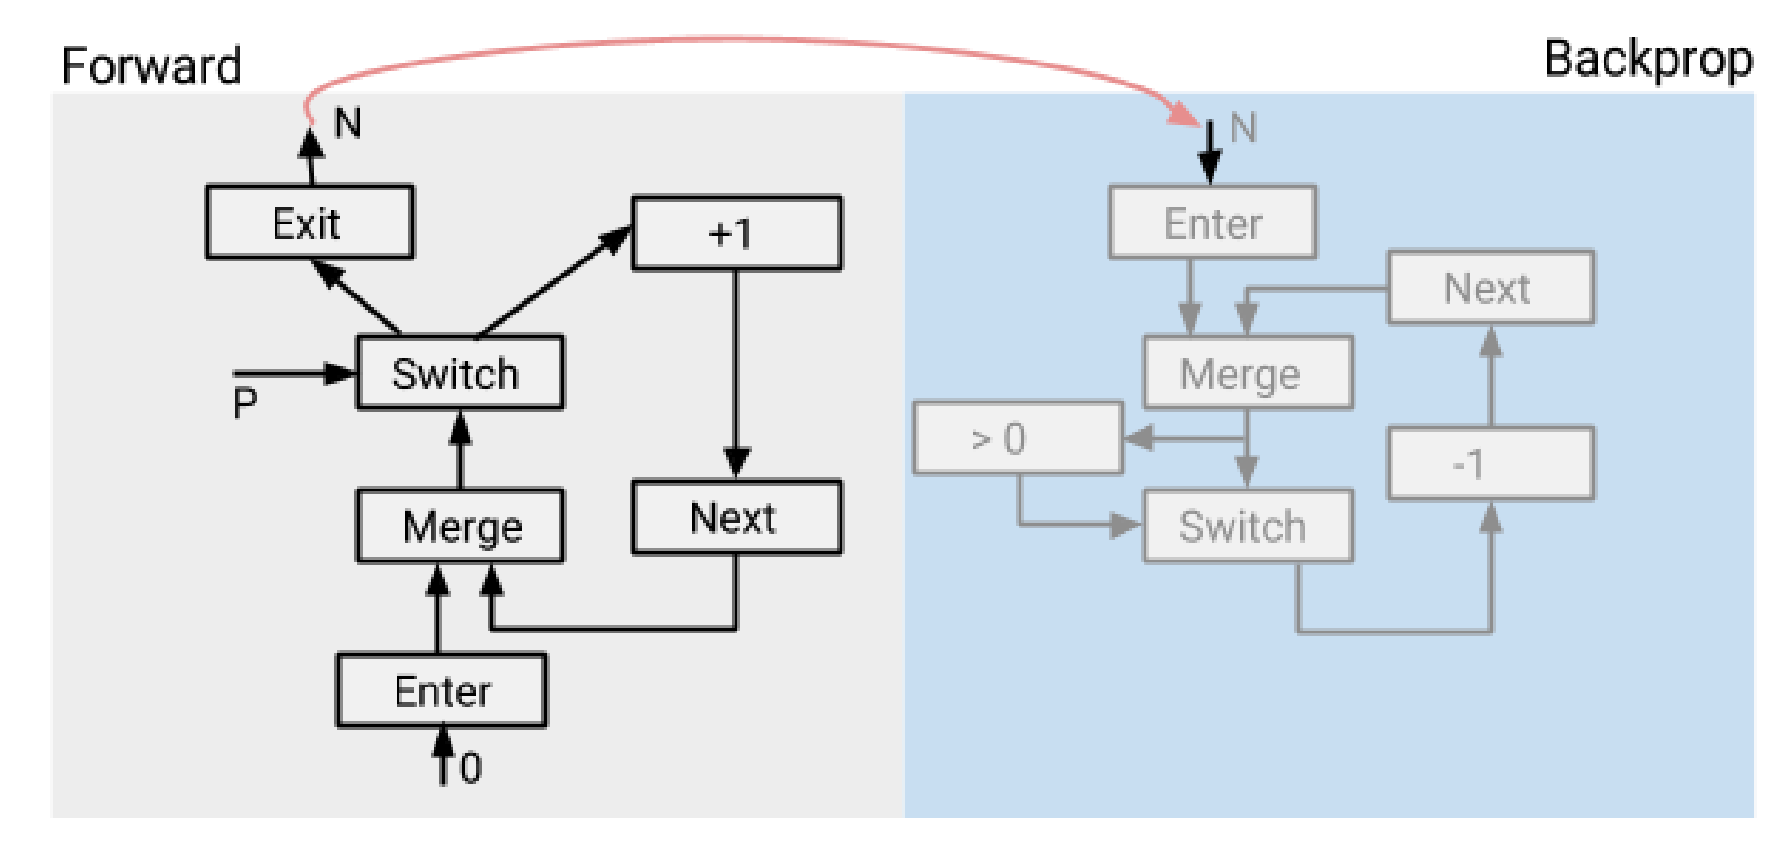
注意在前向传播和反向传播的过程中可能会有若干可以复用的计算结果,这些结果由Tensorflow检测出来并且维护在一个栈结构中,这个栈的Push和Pop操作是异步的
5. AI编译器和前端技术
AI编译器和前端技术
编译器一般将编译阶段分为三个部分,前端、中间表示和后端
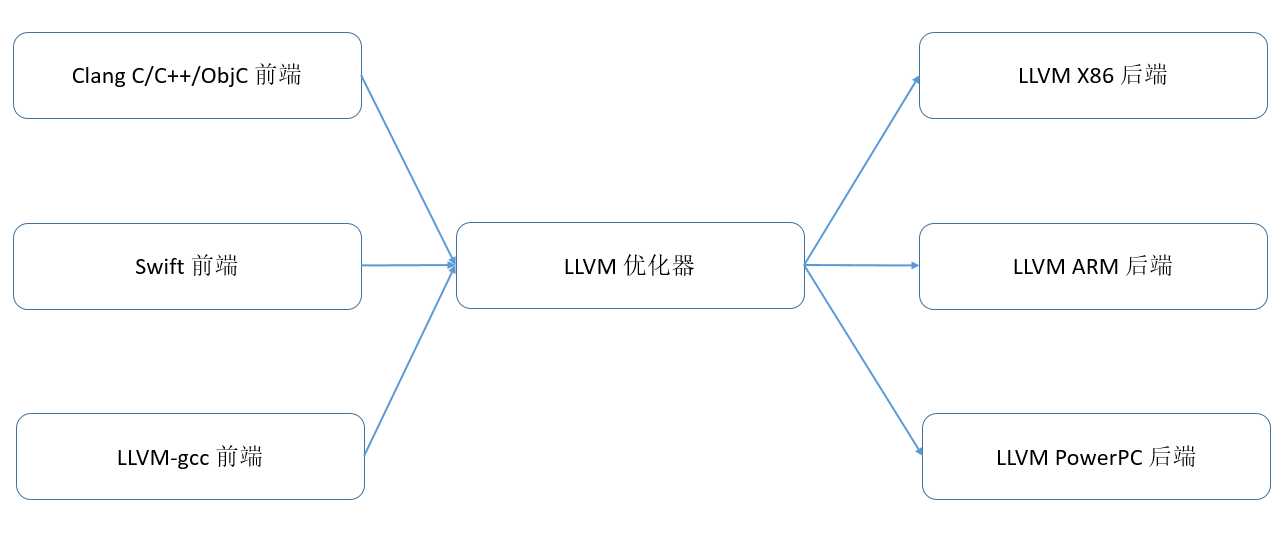
中间表示(IR)可以设计为单层或者多层,AI编译器通常将IR设计为多层
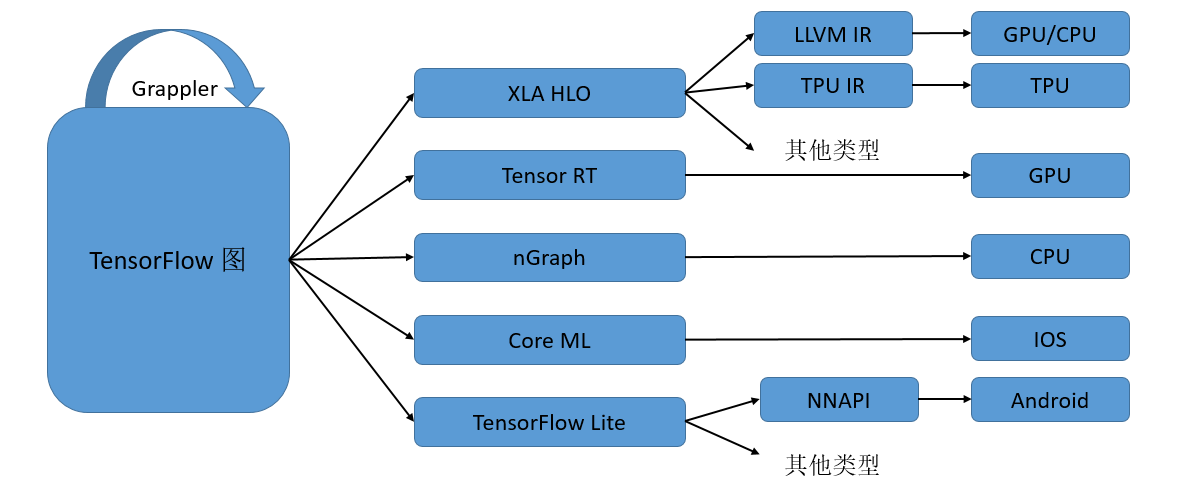
TensorFlow利用MLIR实现多层IR设计(被称为TensorFlow-MLIR)。其包含了三个层次的IR,即TensorFlow Graph IR, XLA(Accelerated Linear Algebra,加速线性代数)、HLO(High Level Operations,高级运算)以及特定硬件的LLVM IR 或者TPU IR
机器学习框架的中间表示
设计机器学习框架的中间表示时,需要充分考虑以下因素:
- 张量表达
- 自动微分
- 计算图模式:机器学习框架的中间表示设计同时支持静态图和动态图
- 支持高阶函数和闭包
- 编译优化
- JIT能力
Pytorch的中间表示
PyTorch框架提供了TorchScript方法,用于创建可序列化和可优化模型。TorchScript IR作为PyTorch模型的中间表示,通过JIT即时编译的形式,将Python代码转换成目标模型文件。任何TorchScript程序都可以在Python进程中保存,并加载到没有Python依赖的进程中。
PyTorch框架提供了TorchScript方法,用于创建可序列化和可优化模型。TorchScript IR作为PyTorch模型的中间表示,通过JIT即时编译的形式,将Python代码转换成目标模型文件。任何TorchScript程序都可以在Python进程中保存,并加载到没有Python依赖的进程中。
import torch

@torch.jit.script
def test_func(input):
    rv = 10.0
    for i in range(5):
        rv = rv + input
        rv = rv/2
    return rv

print(test_func.graph)
graph(%input.1 : Tensor):
  %9 : int = prim::Constant[value=1]()
  %5 : bool = prim::Constant[value=1]() # test.py:6:1
  %rv.1 : float = prim::Constant[value=10.]() # test.py:5:6
  %2 : int = prim::Constant[value=5]() # test.py:6:16
  %14 : int = prim::Constant[value=2]() # test.py:8:10
  %rv : float = prim::Loop(%2, %5, %rv.1) # test.py:6:1
    block0(%i : int, %rv.9 : float):
      %rv.3 : Tensor = aten::add(%input.1, %rv.9, %9) # <string>:5:9
      %12 : float = aten::FloatImplicit(%rv.3) # test.py:7:2
      %rv.6 : float = aten::div(%12, %14) # test.py:8:7
      -> (%5, %rv.6)
  return (%rv)
TensorFLow的静态图中间表示
TensorFlow机器学习框架的静态图机制更为人所熟知。在静态图机制中,运行TensorFlow的程序会经历一系列的抽象以及分析,程序会逐步从高层的中间表示向底层的中间表示进行转换,我们把这种变换成为lowering。
为了适配不同的硬件平台,基于静态计算图,TensorFlow采用了多种IR设计,其编译生态系统如图所示。蓝色部分是基于图的中间表示,绿色部分是基于SSA的中间表示。在中间表示的转换过程中,各个层级的中间表示各自为政,无法互相有效地沟通信息,也不清楚其他层级的中间表示做了哪些优化,因此每个中间表示只能尽力将当前的优化做到最好,造成了很多优化在每个层级的中间表示中重复进行, 从而导致优化效率的低下。尤其是从图中间表示到SSA中间表示的变化过大,转换开销极大。此外,各个层级的相同优化的代码无法复用,也降低了开发效率。
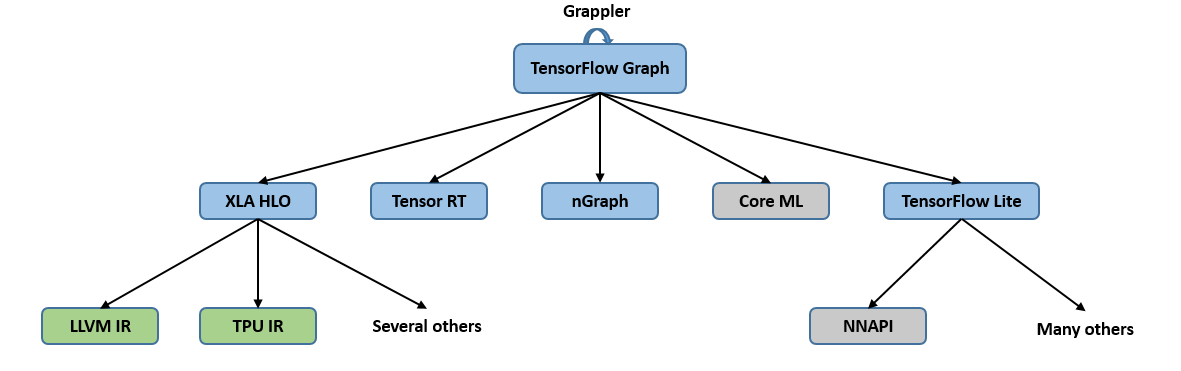
针对这个问题,TensorFlow团队提出了MLIR(Multi-Level Intermediate Represent,多级中间表示) [2020MLIR]。MLIR不是一种具体的中间表示定义,而是为中间表示提供一个统一的抽象表达和概念。 开发者可以使用MLIR开发的一系列基础设施,来定义符合自己需求的中间表示, 因此我们可以把MLIR理解为“编译器的编译器”。MLIR不局限于TensorFlow框架, 还可以用于构建连接其他语言与后端(如LLVM)的中间表示。
自动微分
自动微分:自动微分的思想是将计算机程序中的运算操作分解为一个有限的基本操作集合,且集合中基本操作的求导规则均为已知,在完成每一个基本操作的求导后,使用链式法则将结果组合得到整体程序的求导结果。自动微分是一种介于数值微分和符号微分之间的求导方法,结合了数值微分和符号微分的思想。相比于数值微分,自动微分可以精确地计算函数的导数;相比符号微分,自动微分将程序分解为基本表达式的组合,仅对基本表达式应用符号微分规则,并复用每一个基本表达式的求导结果,从而避免了符号微分中的表达式膨胀问题。而且自动微分可以处理分支、循环和递归等控制流语句。目前的深度学习框架基本都采用自动微分机制进行求导运算
自动微分的类型
自动微分分为前向模式和反向模式,想要对一个函数求导的时候,想要得到的是该函数的仁义一个输入的偏微分集合,对于一个带有n个独立输入
注意这个矩阵是定义计算的时候就已知的,如果利用前向模式计算微分,计算的是函数f的所有输出对于某个输入的偏微分,则可以初始化
而如果使用反向模式计算微分,每次计算的是函数f的某一个输出对任一输入的偏微分,也就是矩阵的某一行,因此通过m次反向模式自动微分就能够得到整个矩阵的计算结果
由于前向和反向模式的迭代次数分别与雅可比矩阵的行数和列数相关,因此在函数的输出个数远远大于输入个数的时候,前向模式效率更高,而当函数的输入个数远远大于输出个数的时候,反向模式效率更高
反向模式存在一定的缺陷,由于求导模式与源程序执行顺序是相反的,计算过程需要分为两个阶段,第一个阶段先执行源程序,且将源程序的中间结果保存起来,在第二阶段才把中间结果取出来去计算导数。因此反向模式会有额外的内存消耗。业界也一直在研究反向模式的内存占用优化方法,例如检查点策略(checkpointing strategies)和数据流分析(data-flow analysis)
自动微分的实现
- 基本表达式法
- 操作符重载法:Pytorch使用了这个方法
- 代码变换法:TensorFlow和MindSpore使用了这个方法
- 基于Tape的方式
- 基于闭包(closure)的方式
类型系统和静态分析技术
类型系统
程序设计语言中,类型是指数值、表达式、函数等属性内容。类型系统是指类型的集合以及使用类型来规定程序行为的规则。类型系统用于定义不同的类型,指定类型的操作和类型之间的相互作用,广泛应用于编译器、解释器和静态检查工具中。类型系统提供的主要功能有:
- 正确性。编译器的类型系统引入了类型检查技术,用于检测和避免运行时错误,确保程序运行时的安全性。通过类型推导与检查,编译器能够捕获大多数类型相关的异常报错,避免执行病态程序导致运行时错误,保证内存安全,避免类型间的无效计算和语义上的逻辑错误。
- 优化。静态类型检查可以提供有用的信息给编译器,从而使得编译器可以应用更有效的指令,节省运行时的时间。
- 抽象。在安全的前提下,一个强大的类型系统的标准是抽象能力。通过合理设计抽象,开发者可以更关注更高层次的设计。
- 可读性。阅读代码时,明确的类型声明有助于理解程序代码。
静态分析
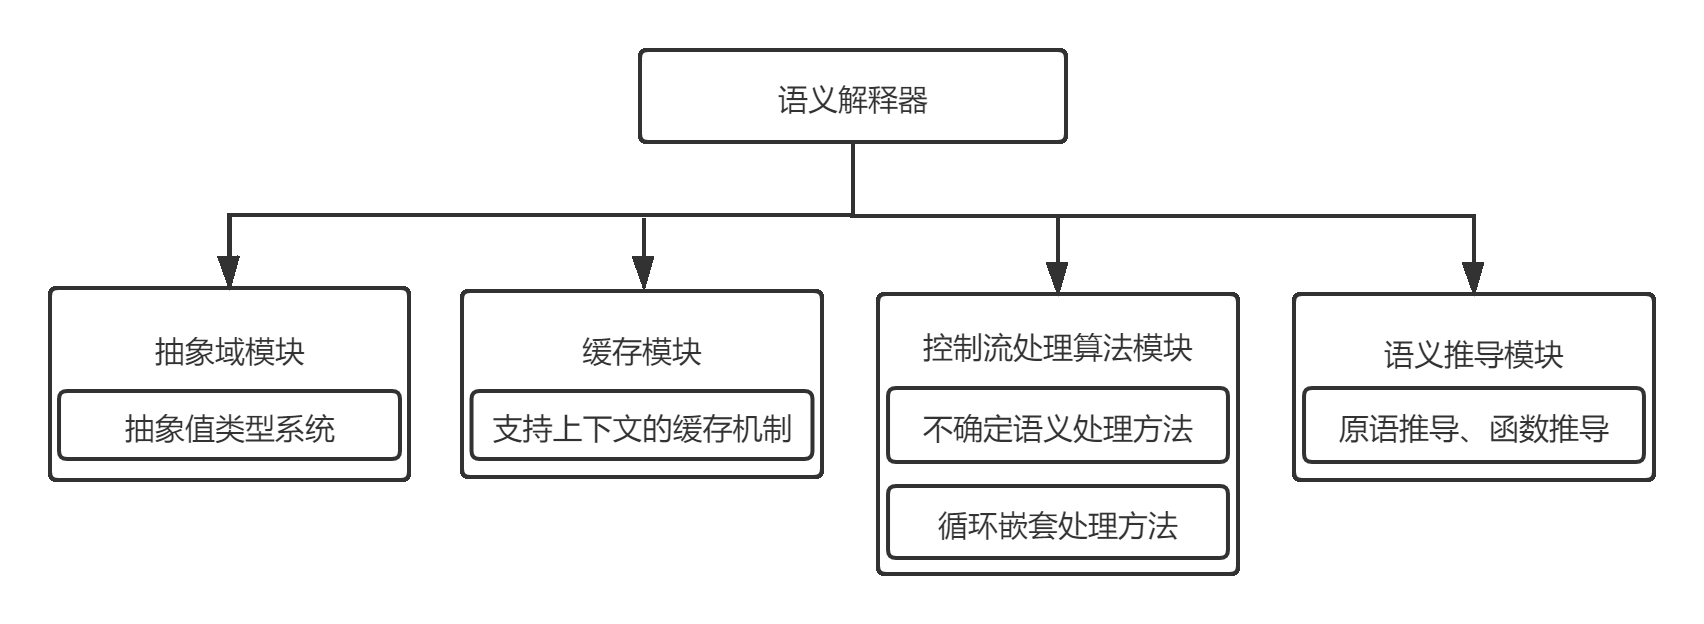
在设计好类型系统后,编译器需要使用静态分析系统来对中间表示进行静态检查与分析。语法解析模块(parser)将程序代码解析为抽象语法树(AST)并生成中间表示。此时的中间表示缺少类型系统中定义的抽象信息,因此引入静态分析模块,对中间表示进行处理分析,并且生成一个静态强类型的中间表示,用于后续的编译优化、自动并行以及自动微分等。在编译器前端的编译过程中,静态分析可能会被执行多次,有些框架还会通过静态分析的结果判断是否终止编译优化。
静态分析模块基于抽象释义对中间表示进行类型推导、常量传播、泛型特化等操作,这些专业术语的含义分别为:
- 抽象释义:通过抽象解释器将语言的实际语义近似为抽象语义,只获取后续优化需要的属性,进行不确定性的解释执行。抽象值一般包括变量的类型和维度。
- 类型推导:在抽象释义的基础上,编译器推断出程序中变量或表达式的抽象类型,方便后续利用类型信息进行编译优化。
- 泛型特化:泛型特化的前提是编译器在编译期间可以进行类型推导,提供类型的上下文。在编译期间,编译器通过类型推导确定调用函数时的类型,然后,编译器会通过泛型特化,进行类型取代,为每个类型生成一个对应的函数方法。
前端编译优化
机器学习编译器也会进行编译优化,意在解决编译生成的中间表示的低效性,使得代码的长度变短,编译与运行的时间减少,执行期间处理器的能耗变低,因为前端是不感知具体后端硬件的,因此前端执行的全部都是与硬件无关的编译优化
常用的编译优化方法实现
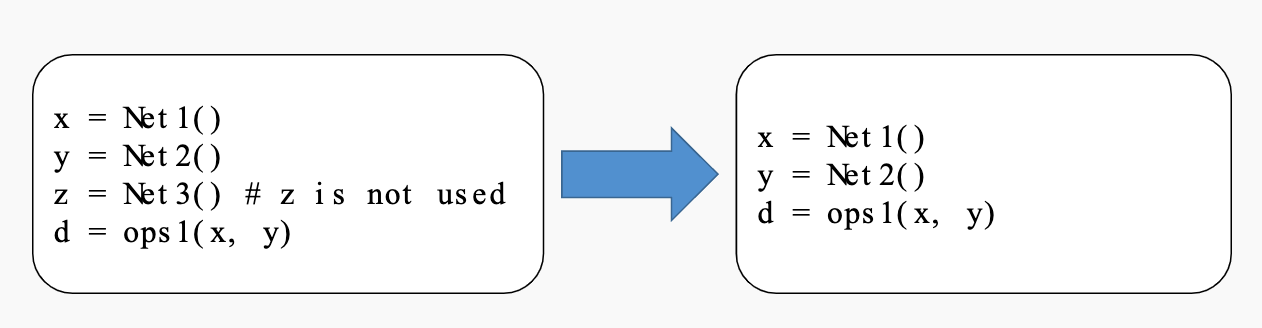
- 无用与不可达代码消除
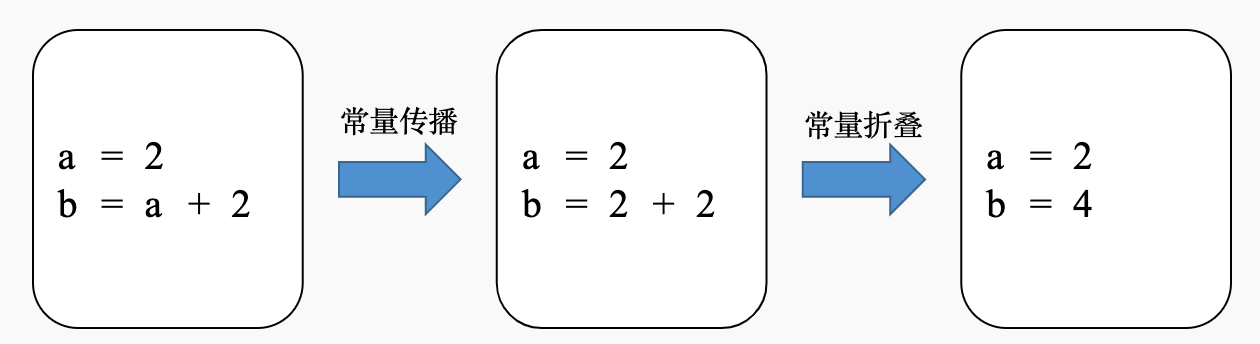
- 常量传播、常量折叠
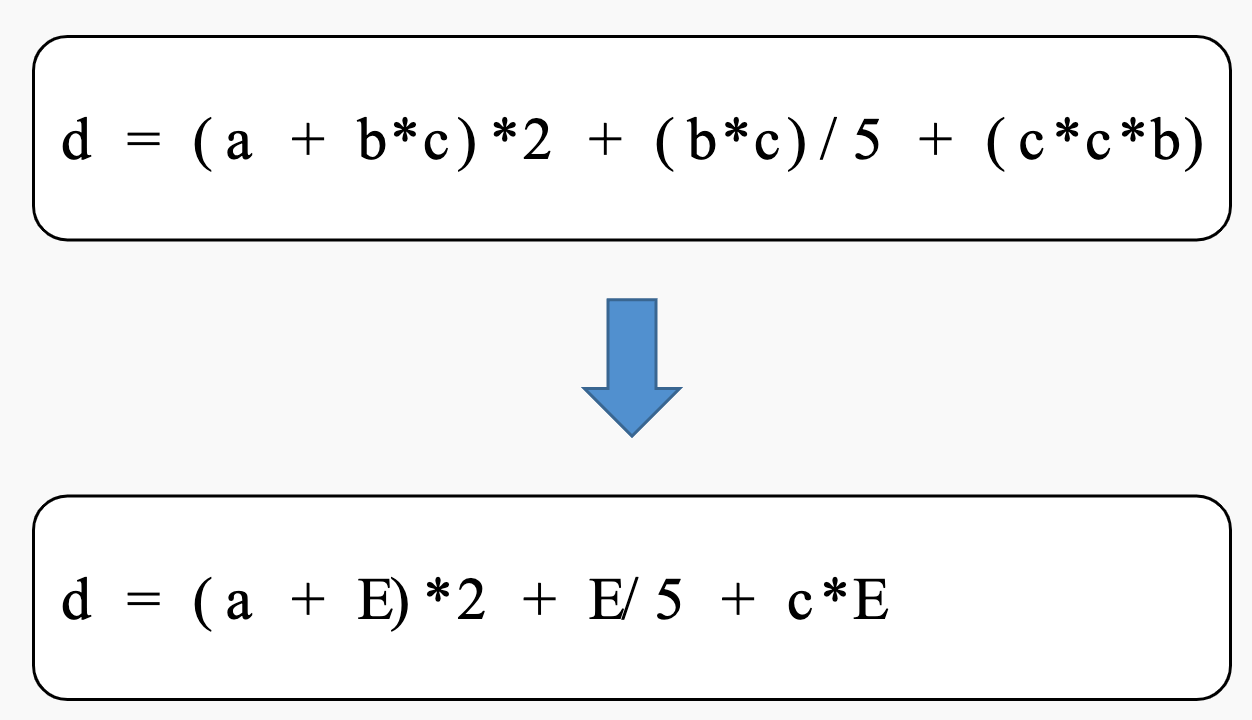
- 公共子表达式
7. 编译器后端和运行时
编译器前端主要是将用户代码进行翻译得到计算图 IR,并对其进行设备信息无关的优化,此时的优化并不考虑程序执行的底层硬件信息。编译器后端的主要职责是对前端下发的 IR 做进一步的计算图优化,让其更加贴合硬件,并为 IR 中的计算节点选择在硬件上执行的算子,然后为每个算子的输入输出分配硬件内存,最终生成一个可以在硬件上执行的任务序列。
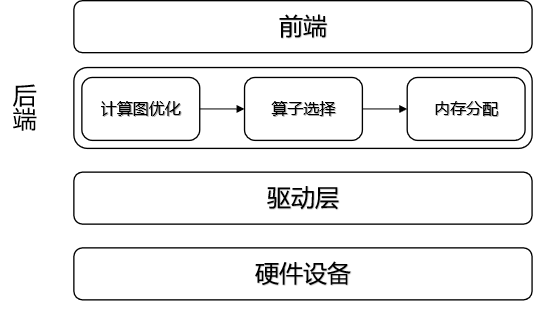
- 计算图优化:计算图优化是在不影响模型的数值特性的基础上,通过图变换达到简化计算、减少资源开销、适配硬件的执行能力、提升执行性能的目的。
- 算子融合
- 算子拆分
- 算子选择:算子选择是将 IR 图上的每个计算节点映射到设备上可执行算子的过程,一个 IR 图上的计算节点往往可以对应多个设备上的算子,这个过程中需要考虑算子的规格,算子的执行效率等问题,算子选择目标就是从中选择最优的一个算子。
- 内存分配:经过计算图优化和算子选择之后,我们可以得到 IR 图中每个算子的输入输出的形状(Shape)、数据类型、存储格式。根据这些信息,计算输入输出数据的大小,并为输入输出分配设备上的内存,然后将算子加载到设备上才能真正执行计算。此外,为了更充分地例用设备内存资源,可以对内存进行复用,提高内存利用率。
- 计算调度与执行:经过算子选择与内存分配之后,计算任务可以通过运行时完成计算的调度与在硬件上的执行。根据是否将算子编译为计算图,计算的调度可以分为单算子调度与计算图调度两种方式。而根据硬件提供的能力差异,计算图的执行方式又可以分为逐算子下发执行的交互式执行以及将整个计算图或者部分子图一次性下发到硬件的下沉式执行两种模式。
- 算子编译器:作为 AI 编译器中一个重要组成部分,算子编译器把单个简单或复杂的算子经过表达和优化后编译为一个单独的可执行文件。目前业界面对算子编译器仍有许多有趣的问题尚未得出明确结论,相关的处理逻辑与方法也尚未收敛。
对于某些前端 IR 的子集来说,一个算子便能够执行对应的功能,此时可以将这些 IR 节点合并成为一个计算节点,该过程称之为算子融合;对于一些复杂计算,后端并没有直接与之对应的算子,但是可以通过几个基本运算的算子组合达到同样的计算效果,此时可以将前端 IR 节点拆分成多个小算子。在完成计算图优化之后,就要进行算子选择过程,为每个计算节点选择执行算子。算子选择是在得到优化的 IR 图后选取最合适的目标设备算子的过程。针对用户代码所产生的 IR 往往可以映射成多种不同的硬件算子,但是这些不同硬件算子的执行效率往往有很大差别,如何根据前端 IR 选择出最高效的算子,是算子选择的核心问题。算子选择本质上是一个模式匹配问题。其最简单的方法就是每一个 IR 节点对应一个目标硬件的算子,但是这种方法往往对目标硬件的资源利用比较差。现有的编译器一般都对每一个 IR 节点提供了多个候选的算子,算子选择目标就是从中选择最优的一个算子作为最终执行在设备上的算子。
计算图优化
根据优化适用于所有硬件还是只适合特定硬件,可以分为通用硬件优化和特定硬件优化,例如为了适配硬件指令限制而做的子图变换和与特定硬件无关的算子内存 IO 优化
通用硬件优化
深度学习算子按照其对资源的需求可以分为两类:
- 计算密集型算子:如卷积、全连接等
- 访存密集型算子:大部分是 Element-Wise 算子,例如 ReLU、Element-Wise Sum 等
一般两种算子是结伴出现的,例如“Conv+ReLU”,将二者融合成一个算子来计算,从而减少内存访问延时和带宽压力,提高执行效率
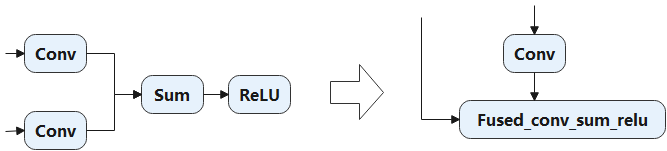
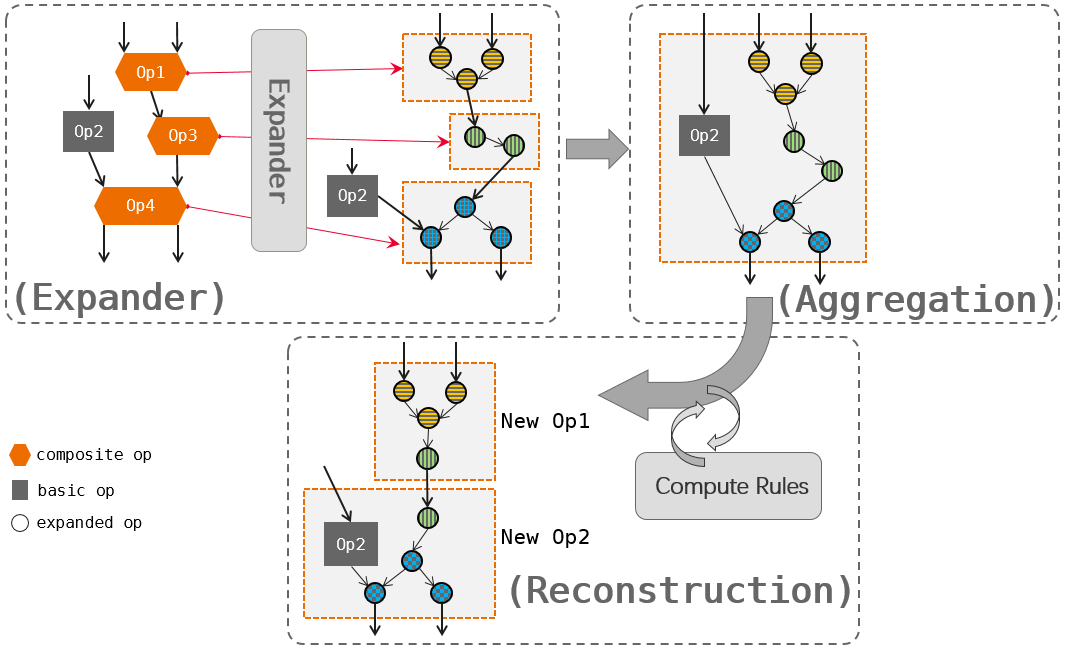
MindSpore 的图算融合技术为例,图算融合通过“算子拆解、算子聚合、算子重建”三个主要阶段让计算图中的计算更密集,并进一步减少低效的内存访问。
特定硬件优化
常见的异域硬件的优化包括由于硬件指令的限制而做的优化,特定硬件存储格式导致的优化等。
硬件指令限制
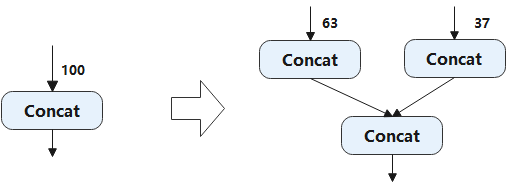
在一些特定的硬件上,IR 中计算节点没有直接对应的硬件算子,只能通过子图的变换来达到子图中所有算子在对应的硬件上的存在。例如在 MindSpore 中,昇腾芯片上的 Concat 算子,只支持有限的输入个数(63个),因此当前端 IR 上的输入个数大于限制输入的时候,需要将该计算节点拆分成等价的多个 Concat 节点。
数据排布格式的限制
针对不同特点的计算平台和不同的算子,为了追求最好的性能,一般都需要选择不同的数据排布格式(Format),而这些排布格式可能跟框架缺省的排布格式是不一样的。
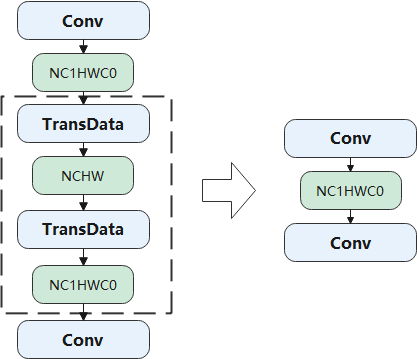
虚线框内的两个转换操作互为逆操作,可以相互抵消。通过对计算图的模式匹配,可以将该类型的操作消除。
算子选择
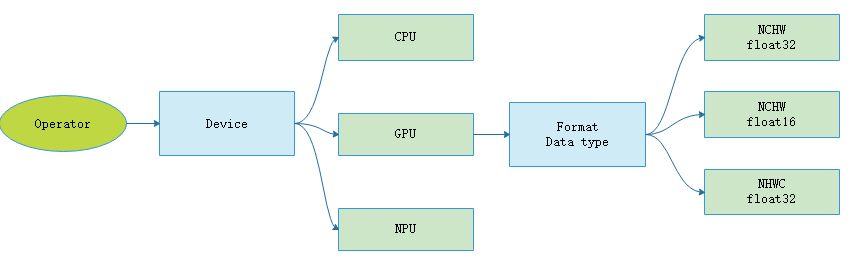
经历了后端的图优化后,IR 图中的每一个节点都有一组算子与之对应。此时的 IR 图中的每一个节点可以认为是用户可见的最小硬件执行单元,代表了用户代码的一个操作,对于这个操作还没有具体生成有关设备信息的细节描述。这些信息是算子选择所选择的内容信息,称之为算子信息。算子信息主要包括以下内容:
- 针对不同特点的计算平台和不同的算子,为了追求最好的性能,一般都需要选择不同的数据排布格式。机器学习系统常见的数据排布格式有 NCHW 和 NHWC 等。
- 对于不同的硬件支持不同的计算精度,例如 float32、float16和 int32等。算子选择需要在所支持各种数据类型的算子中选择出用户所设定的数据类型最为相符的算子。
数据排布格式
机器学习系统中很多运算都会转换成为矩阵的乘法,例如卷积运算。我们知道矩阵乘法
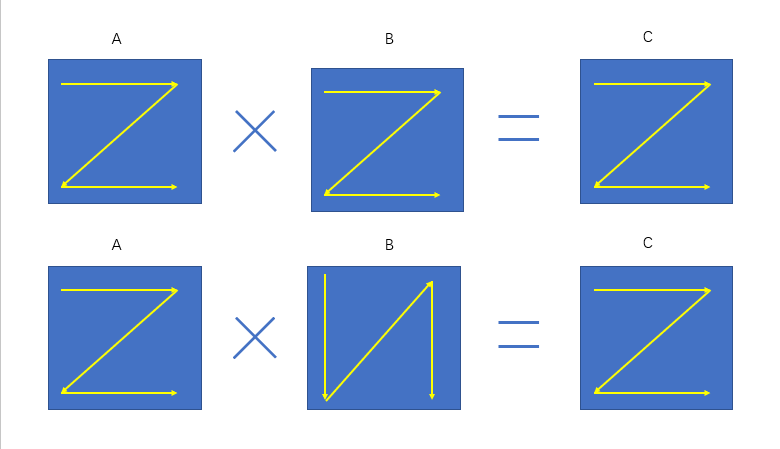
计算机的存储并不能够直接将这样的矩阵放到内存中,需要将其展平成1维后存储,这样就涉及逻辑上的索引如何映射成为内存中的索引,即如何根据逻辑数据索引来映射到内存中的1维数据索引。
对于 NCHW 的数据是先取 W 轴方向数据,再取 H 轴方向数据,再取 C 轴方向,最后取 N 轴方向。其中物理存储与逻辑存储的之间的映射关系为
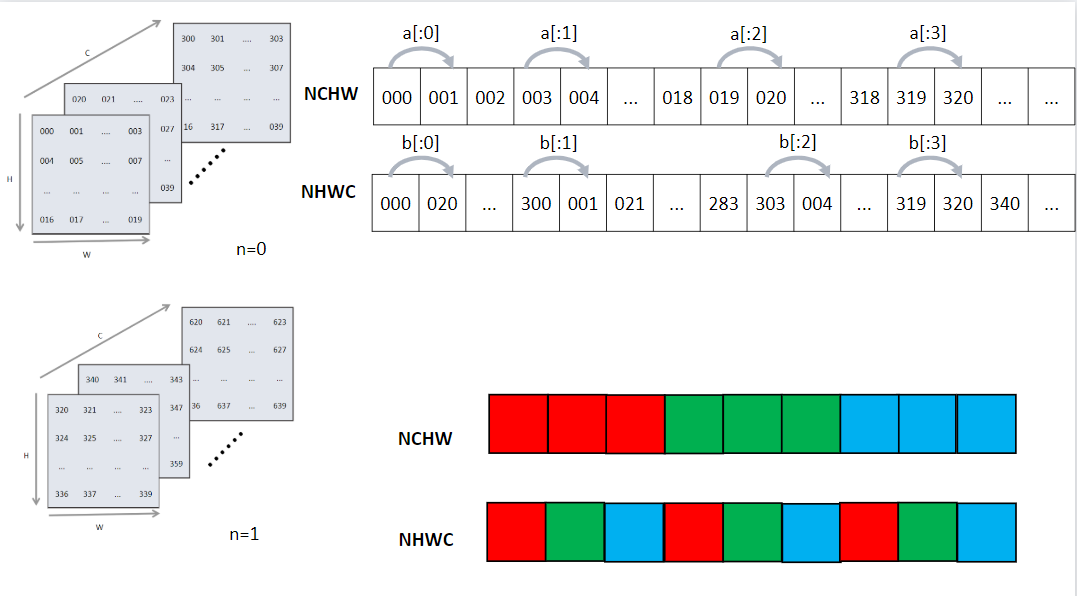
机器学习系统中,用户输入的数据往往会远远大于计算部件一次性计算所能容纳的最大范围,所以此时必须将输入的数据进行切片分批送到运算部件中进行运算。为了加速运算很多框架又引入了一些块布局格式来进行进一步的优化,这种优化可以使用一些硬件的加速指令,对数据进行搬移和运算。比如 oneDNN 上的 nChw16c 和 nChw8c 格式,以及 Ascend 芯片的5HD 等格式。这种特殊的数据格式与硬件更为贴合,可以快速的将矩阵向量化,并且极大的利用片内缓存。
算子选择过程
内存分配
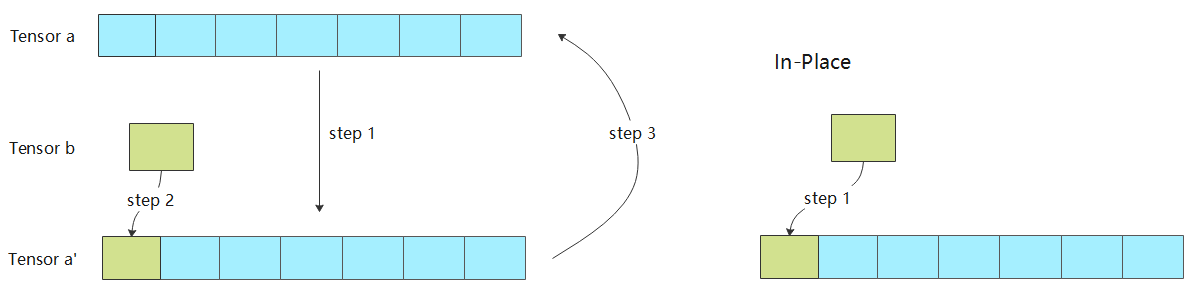
随着深度学习的发展,深度神经网络的模型越来越复杂,AI 芯片上的内存很可能无法容纳一个大型网络模型。因此,对内存进行复用是一个重要的优化手段。此外,通过连续内存分配和 In-Place 内存分配还可以提高某些算子的执行效率。
Device 内存
在深度学习体系结构中,通常将与硬件加速器(如 GPU、AI 芯片等)相邻的内存称之为设备(Device)内存,而与 CPU 相邻的内存称之为主机(Host)内存。CPU 可以合法地访问主机上的内存,而无法直接访问设备上的内存;同理,AI 芯片可以访问设备上的内存,却无法访问主机上的内存。
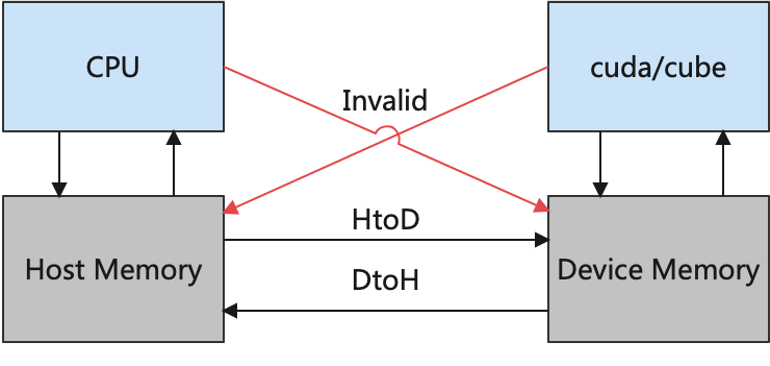
内存申请
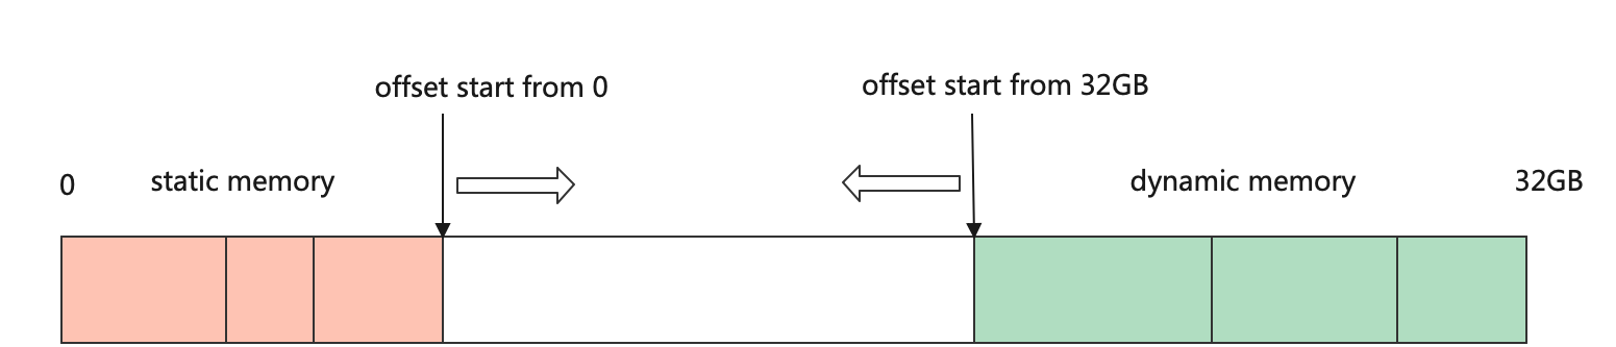
在深度学习框架中,设备内存的申请也是非常频繁的,往往也是通过内存池的方式去管理设备内存,并让设备内存的生命周期与张量的生命周期保持一致。不同的深度学习框架在内存池的设计上大同小异,以:numref: device_malloc 的 MindSpore 框架内存申请为例,进程会从设备上申请足够大的内存,然后通过双游标从两端偏移为张量分配内存。首先从申请的首地址开始进行偏移,为算子权重的张量分配内存,这部分张量生命周期较长,往往持续整个训练过程。然后从申请设备地址的末尾开始偏移,为算子的输出张量分配内存,这部分内存的生命周期较短,往往在该算子计算结束并且后续计算过程中无需再次使用该算子的输出的情况下,其生命周期就可以结束。通过这种方式,只需要从设备上申请一次足够大的内存,后续算子的内存分配都是通过指针偏移进行分配,减少了直接从设备申请内存的耗时。
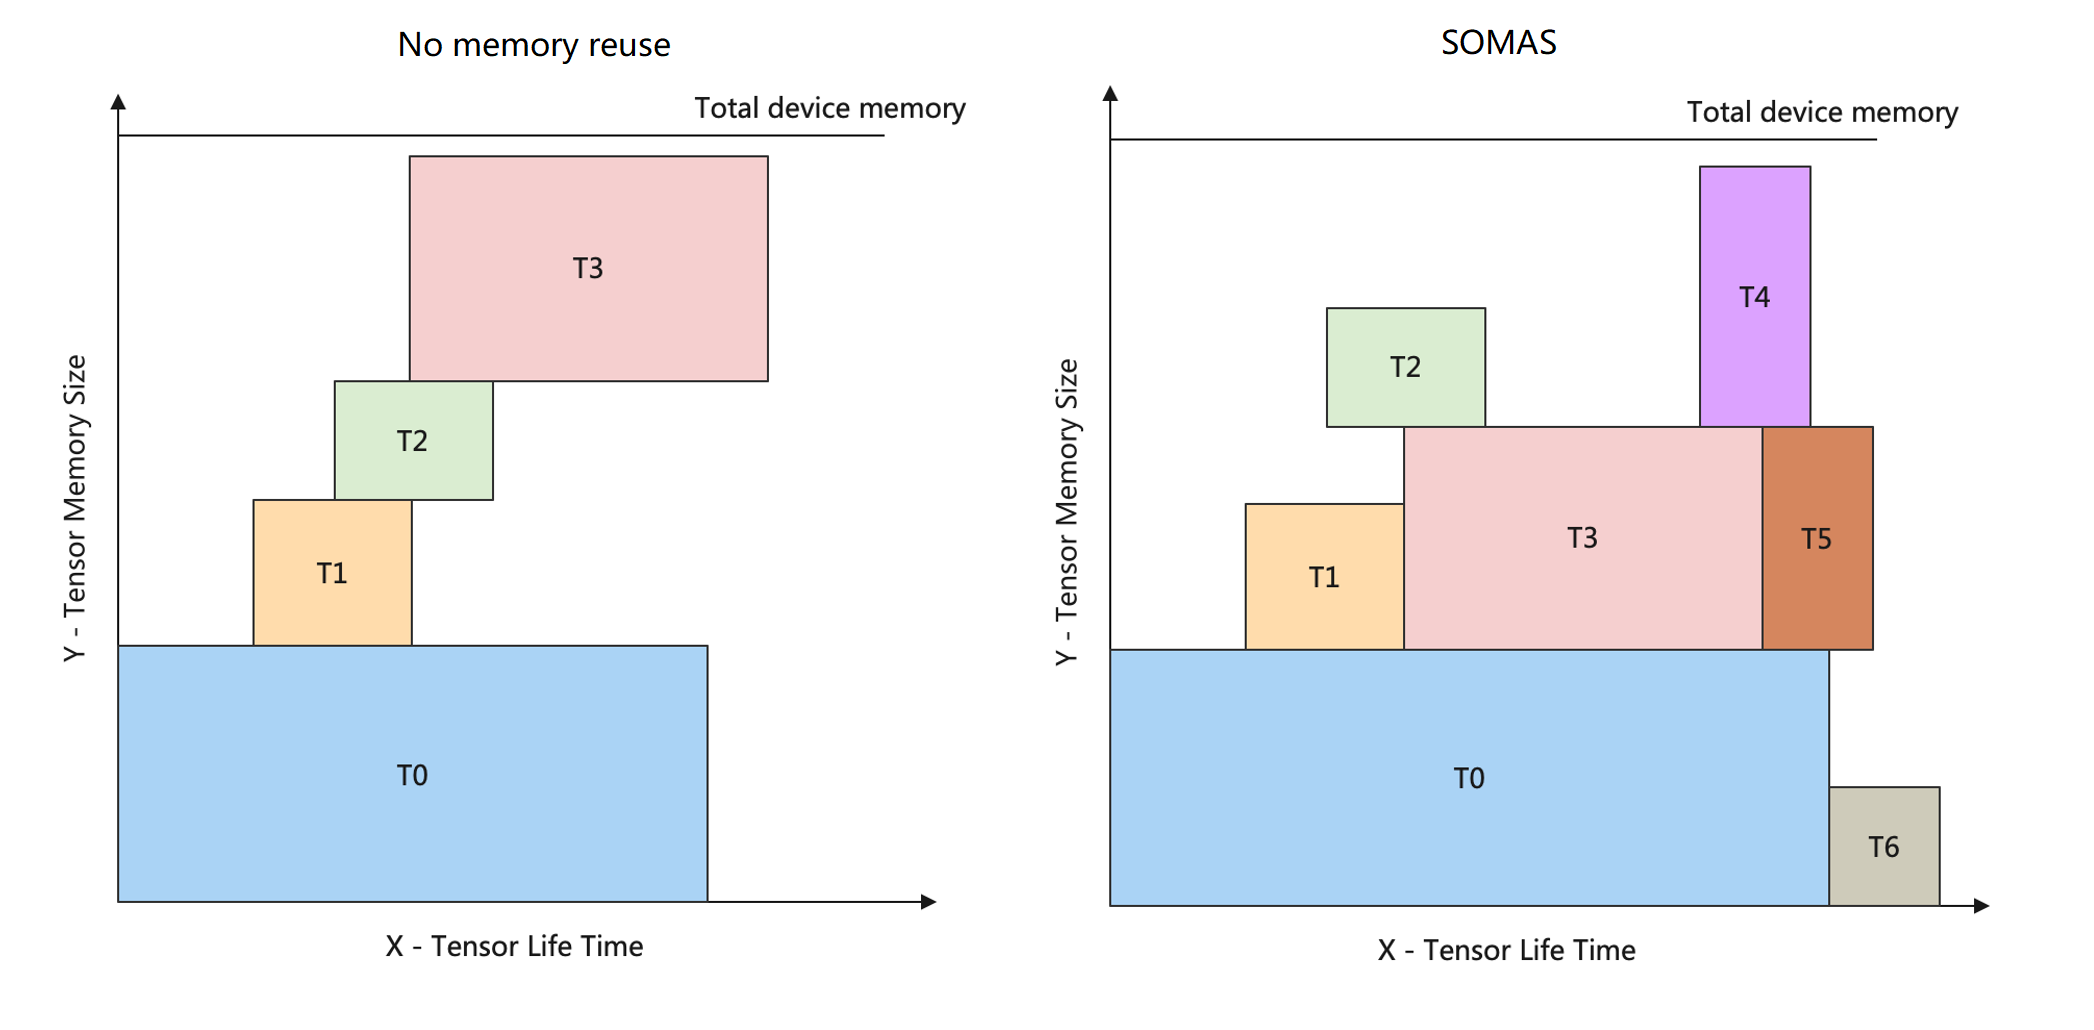
内存复用
内存复用是指分析张量的生命周期,将生命周期结束的张量的设备内存释放回内存池并用于后续张量的内存分配。内存复用的目的是提高内存的利用率,让有限的设备内存容纳更大的模型。
内存融合
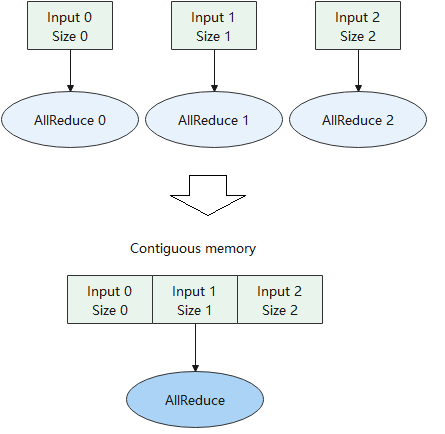
在大规模分布式集群的场景下,通信的耗时往往是性能瓶颈。针对这种场景,如图所示,可以将多个通信算子融合成一个,为通信算子的输入分配连续的内存,从而减少通信的次数。
分布式训练中的神经网络权重初始化,通常将一个训练进程中的权重初始化,然后将该权重广播到其他进程中。当一个网络有较多权重的时候,需要多次进行广播。通常可以为所有权重分配连续的内存地址,然后广播一次,节省大量通信的耗时。
In-Place 算子
当一个算子的作用仅仅是更新某个张量的某部分的时候,就不需要为其分别分配输入输出张量,以节省内存申请次数
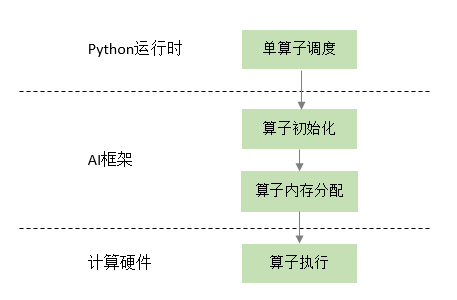
计算调度与执行
- 单算子调度
- 计算图调度
- 逐算子下发执行
- 整个计算图或者部分子图一次性下发到硬件的下沉式执行
单算子调度
又有较强的灵活性
计算图调度
拥有计算图的全局信息,可以根据上下文完成算子融合
一张计算图可以由运行在不同设备上的算子组成为异构计算图
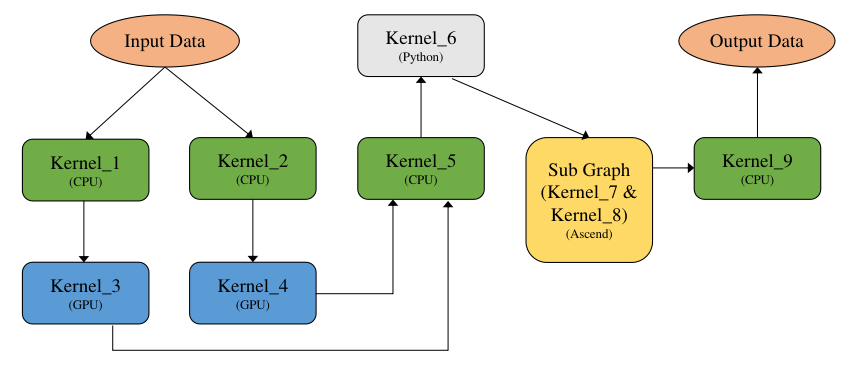
异构计算图的执行分为三种模式:
- 逐算子交互执行:主要针对 CPU 和 GPU 的场景,计算图中的算子按照输入和输出的依赖关系被逐个调度执行
- 整图下沉式执行:主要针对 NPU 芯片,这类芯片可以无需借助主机的 CPU 能力而独立完成计算图中所有算子的调度与执行
- 子图下沉式执行:上述两种方式的集合,由于计算图表达的灵活性,对于复杂场景的计算图在 NPU 芯片上进行整图下沉执行的效率不一定能达到最优,因此可以将对于 NPU 芯片执行效率低下的部分分离出来,交给 CPU 或者 GPU 处理
交互式执行
非异构图的执行方式
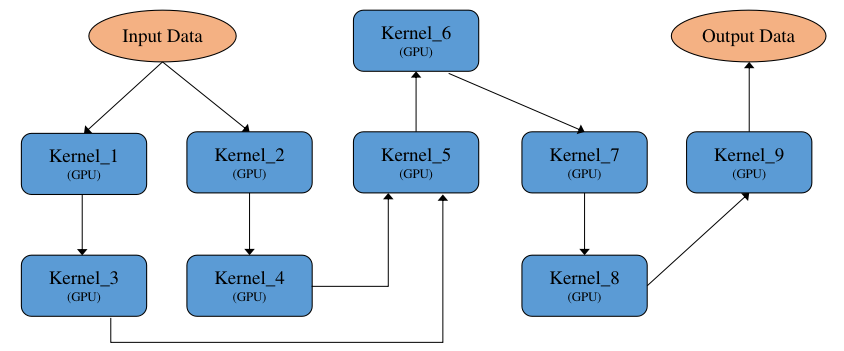
- 串行执行
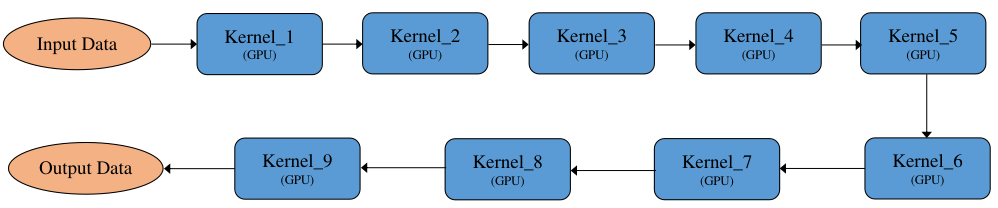
- 并行执行
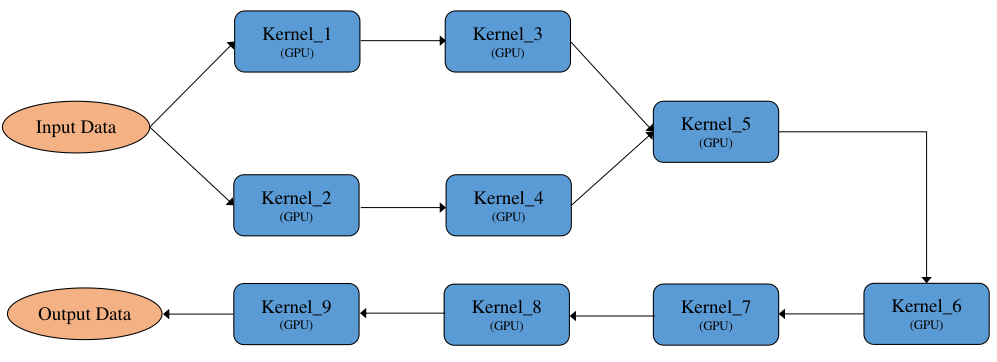
| 执行方式 | 串行执行 | 并行执行 |
|---|---|---|
| 算子执行顺序 | 固定 | 不固定 |
| 算子执行线程 | 单线程 | 多线程 |
| 所需执行资源 | 较低 | 较高 |
异构计算图的执行方式
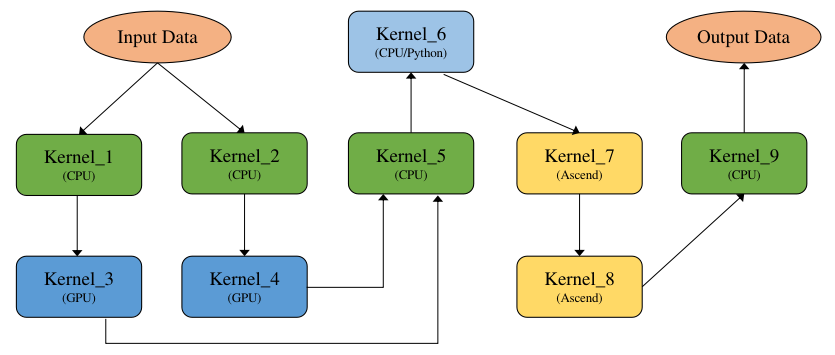
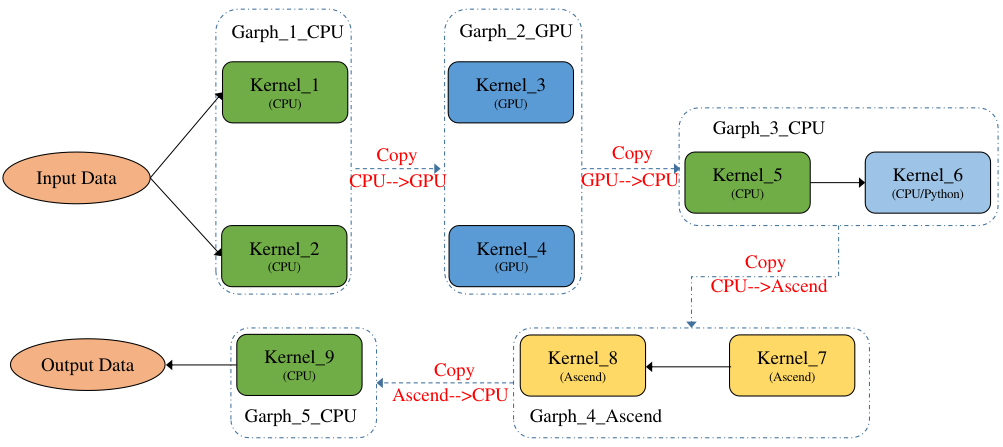
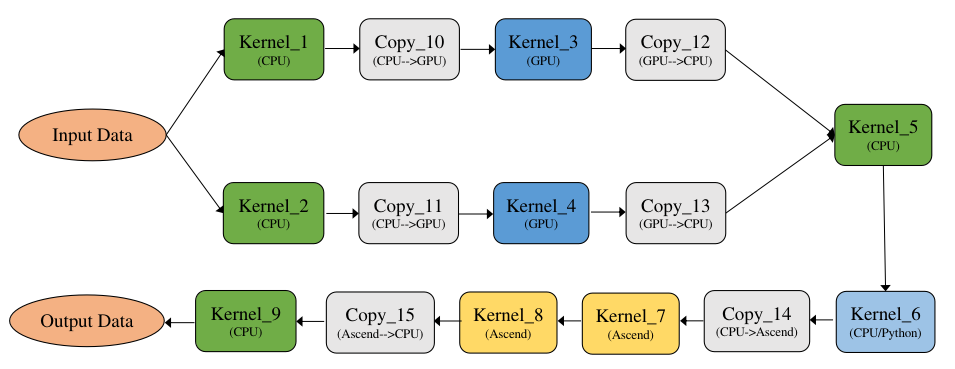
其中 Kernel_1、Kernel_2、Kernel_5、Kernel_9为 CPU 算子,Kernel_6为 python 算子(执行也是在 CPU 上),Kernel_3和 Kernel_4为 GPU 算子,Kernel_7和 Kernel_8为 GPU 算子。
一般来说计算图的优化都是基于非异构计算图来实现的,要求计算图中的算子为同一设备上的,方便算子间的融合替换等优化操作,因此需要将一张异构计算图切分为多个非异构计算图,
切分方式就比较灵活了,可以定义各种切分规则,一般按照产生尽量少的子图的切分规则来切分,尽量将多的同一设备上的算子放在一张子图中
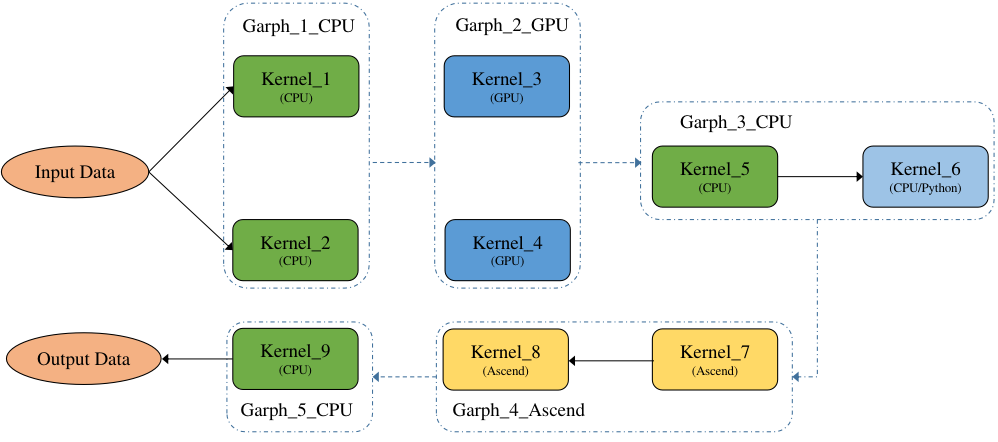
切分完成后,执行方式一般分为子图拆分执行和子图合并执行
-
子图拆分执行:上一个子图的输出数据会传输给下一个子图的输入数据,并且下一个子图需要将输入数据拷贝为本图的 device 数据,子图之间互相切换执行有一定的开销。
-
子图合并执行:通过算子的设备属性来插入拷贝算子以实现不同设备上的算子数据传输,主要是减少子图间切换的开销
| 执行方式 | 子图拆分 | 子图合并 |
|---|---|---|
| 异构数据传输 | 子图之间拷贝 | 算子之间拷贝 |
| 执行额外开销 | 子图切换执行开销 | 无 |
| 执行并发粒度 | 子图并发 | 算子原生并发 |
下沉式执行
下沉式执行是通过专用芯片的 SoC 架构,将整个或部分计算图一次性调度到芯片上以完成全量数据的计算。例如对于 Ascend 芯片,多个 Ascend 算子组成的计算图可以在执行前被编译成为一个 Task,通过 Ascend 驱动程序提供的接口,将包含多个算子的 Task 一次性下发到硬件上调度执行。
算子编译器
从目的上来说,算子编译器致力于提高算子的执行性能。从工程实现上来说,算子编译器的输入一般为 Python 等动态语言描述的张量计算,而输出一般为特定 AI 芯片上的可执行文件。
算子调度策略
在程序实际运行的时候针对数据做出的特殊操作,统称为调度(Schedule)。调度定义了:
(1)应该在何时何处计算函数中的每个值?
(2)数据应该储存在哪里?
(3)每个值在多个消费者(Consumer)之间访存需要花费多长时间?另外在何时由每个消费者独立重新计算?这里的消费者指使用前序结构进行计算的值。
通俗理解,调度策略指的是:在编译阶段根据目标硬件体系结构的特点而设计出的一整套通过提升局部性和并行性而使得编译出的可执行文件在运行时性能最优的算法。这些算法并不会影响计算结果,只是干预计算过程,以达到提升运算速度的效果。
子策略组合优化
将抽象出来的调度策略进行组合,拼接排布出一个复杂而高效的调度集合。子策略组合优化,本质上还是基于人工手动模板匹配的优化方式,依赖于开发人员对于硬件架构有较深的理解。
TVM 中对矩阵乘法有一个优化,例如将张量 A 于张量 B 相乘后,结果累加到张量 C 中,若张量大小均为 1024*1024,则 L1 Cache 无法完整的放下 3 个张量,此时可以选取一个因子进行平铺,平铺后每次计算只需要关注小块即可,而其他外层循环不会影响最内层小块的访存
调度空间算法优化
算子编译器的另外一种优化思路是:通过对调度空间搜索/求解,自动生成对应算子调度。此类方案包括多面体模型编译(Polyhedral Compilation)(基于约束对调度空间求解)和 Ansor(调度空间搜索)等。这类方法的好处是提升了算子编译的泛化能力,缺点是搜索空间过程会导致编译时间过长。以多面体模型编译技术将代码的多层循环抽象为多维空间,将每个计算实例抽象为空间中的点,实例间的依赖关系抽象为空间中的线,主要对循环进行优化。该算法的主要思想是针对输入代码的访存特点进行建模,调整循环语句中的每一个实例的执行顺序,使得新调度下的循环代码有更好的局部性和并行性。
《深度学习编译之多面体模型编译——以优化简单的两层循环代码为例》
8. 硬件加速器
加速器基本组成原理
硬件加速器的存储单元
对于加速器而言,如果没有缓存进行快速存取,DRAM 的带宽非常不足,如果无法快速地在 DRAM 上获取程序和数据,加速器将因空置而降低利用率。为了缓解 DRAM 的带宽问题,GPU 提供了不同层次的若干区域供程序员存放数据,每块区域的内存都有自己的最大带宽以及延迟。开发者需根据不同存储器之间的存储速度的数量级的变化规律,选用适当类型的内存以及最大化地利用它们,从而发挥硬件的最大算力,减少计算时间。
- 寄存器文件(Register File):片上最快的存储器,但与 CPU 不同,GPU 的每个 SM(流多处理器)有上万个寄存器。尽管如此当每个线程使用过多的寄存器时,SM 中能够调度的线程块数量就会受到限制,可执行的线程总数量会因此受到限制,可执行的线程数量过少会造成硬件无法充分的利用,性能急剧下降。所以要根据算法的需求合理使用寄存器。
- 共享内存(Shared Memory):共享内存实际上是用户可控的一级缓存,每个 SM(流多处理器)中有128KB 的一级缓存, 开发者可根据应用程序需要配置最大96KB 的一级缓存作为共享内存。共享内存的访存延迟极低,只有几十个时钟周期。共享内存具有高达1.5TB/s 的带宽,远远高于全局内存的峰值带宽900GB/s。
- 全局内存(Global Memory):全局内存之所以称为全局,是因为 GPU 与 CPU 都可以对它进行读写操作。全局内存对于 GPU 中的每个线程都是可见的,都可以直接对全局内存进行读写操作。CPU 等其他设备可以通过 PCI-E 总线对其进行读写操作。全局内存也是 GPU 中容量最大的一块内存,可达16GB 之多。同时也是延迟最大的内存,通常有高达上百个时钟周期的访存延迟。